如何制作一部 AI 电影
持续关注最佳 AI 模型
视频模型
- 1Seedance 2.5ByteDance
- 2Seedance 2.0ByteDance
- 3Wan 3.0Alibaba
图像模型
- 1Seedream 5.0 ProByteDance
- 2Nano Banana ProGoogle
- 3GPT Image 2OpenAI
由 OpenArt Arena 针对影视用途进行排名,评审团由从业导演和艺术家组成盲评小组。数据截取时间为 15 September 2026。完整详情见下方问题解答。
J2 industries 的电影就是这样做出来的。没有秘密提示词,没有魔法设置,只有一套行之有效的流程。先搭建世界,再锁定角色,然后才开始拍摄。这一切都在 OpenArt 里完成。
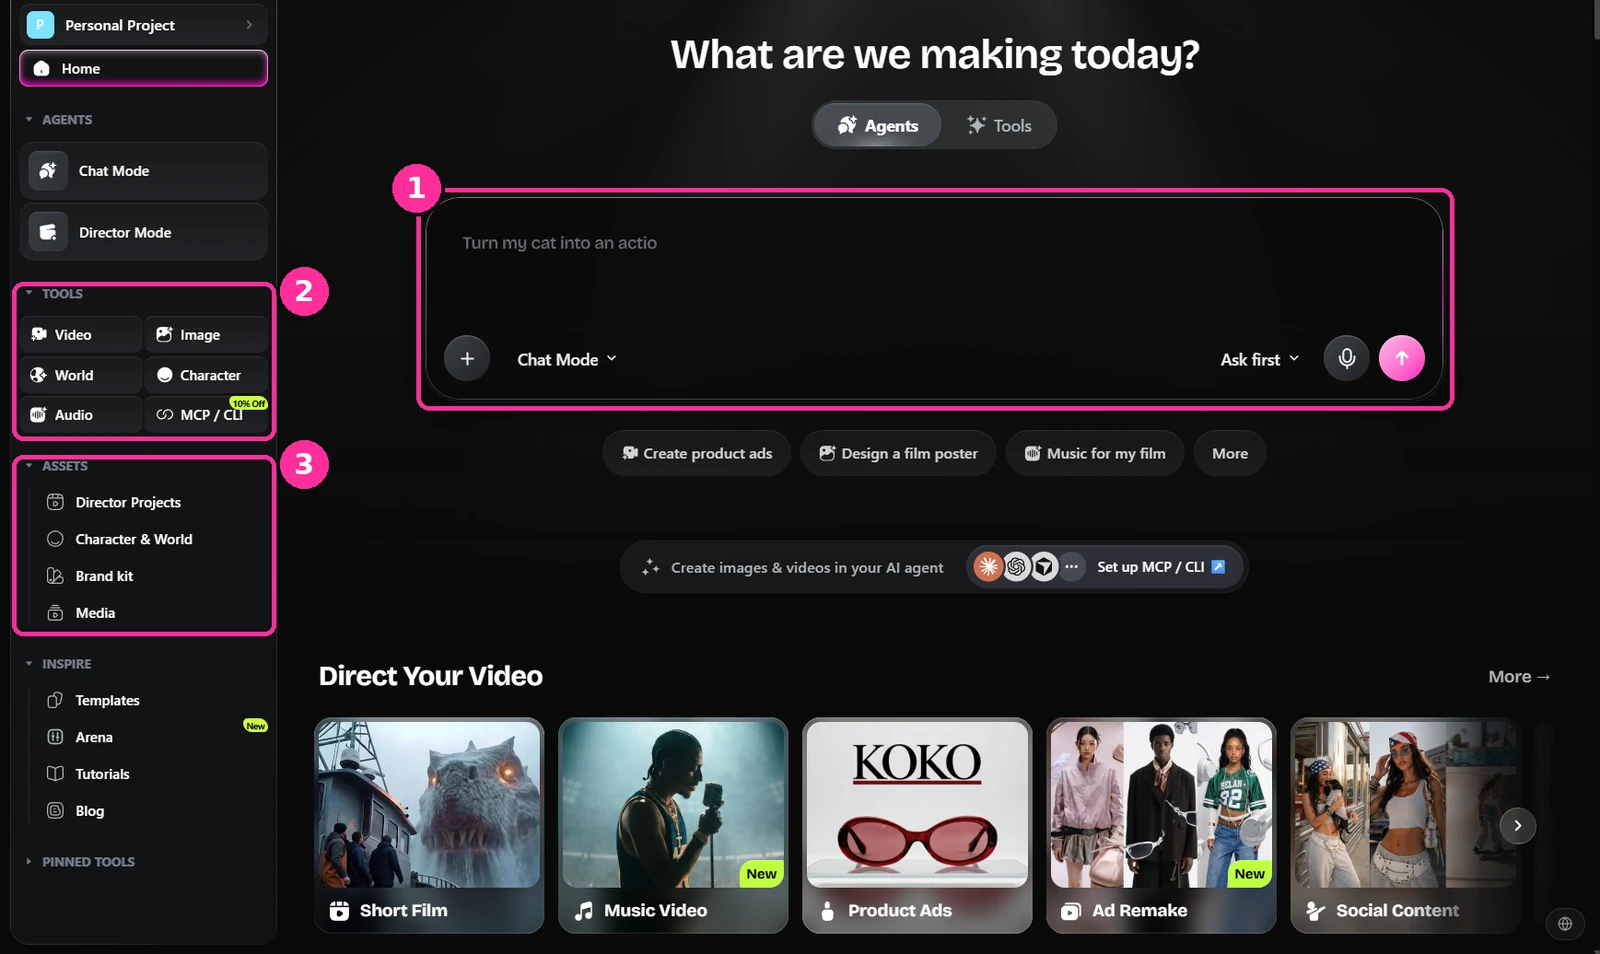
- 提示词输入框。一切从这里开始。你可以在聊天中以对话方式操作,也可以直接进入某个特定工具。
- 工具。视频、图像、世界、角色和音频。这是你将长期使用的清单。
- 素材库。你保存的角色、世界和媒体文件。你在第三步锁定的任何内容都会保存到这里并可重复使用。
搭建场景
从地点开始,而不是镜头。用 Seedream 5.0 Pro 或 GPT Image 2 生成你的环境,并像场景勘察员一样描述它:建筑风格、时间、天气、光线。此时先不用考虑镜头。
在你还处于这个场景时,生成同一地点的多个角度。你之后会用到它们,而一起生成能保持一致性。
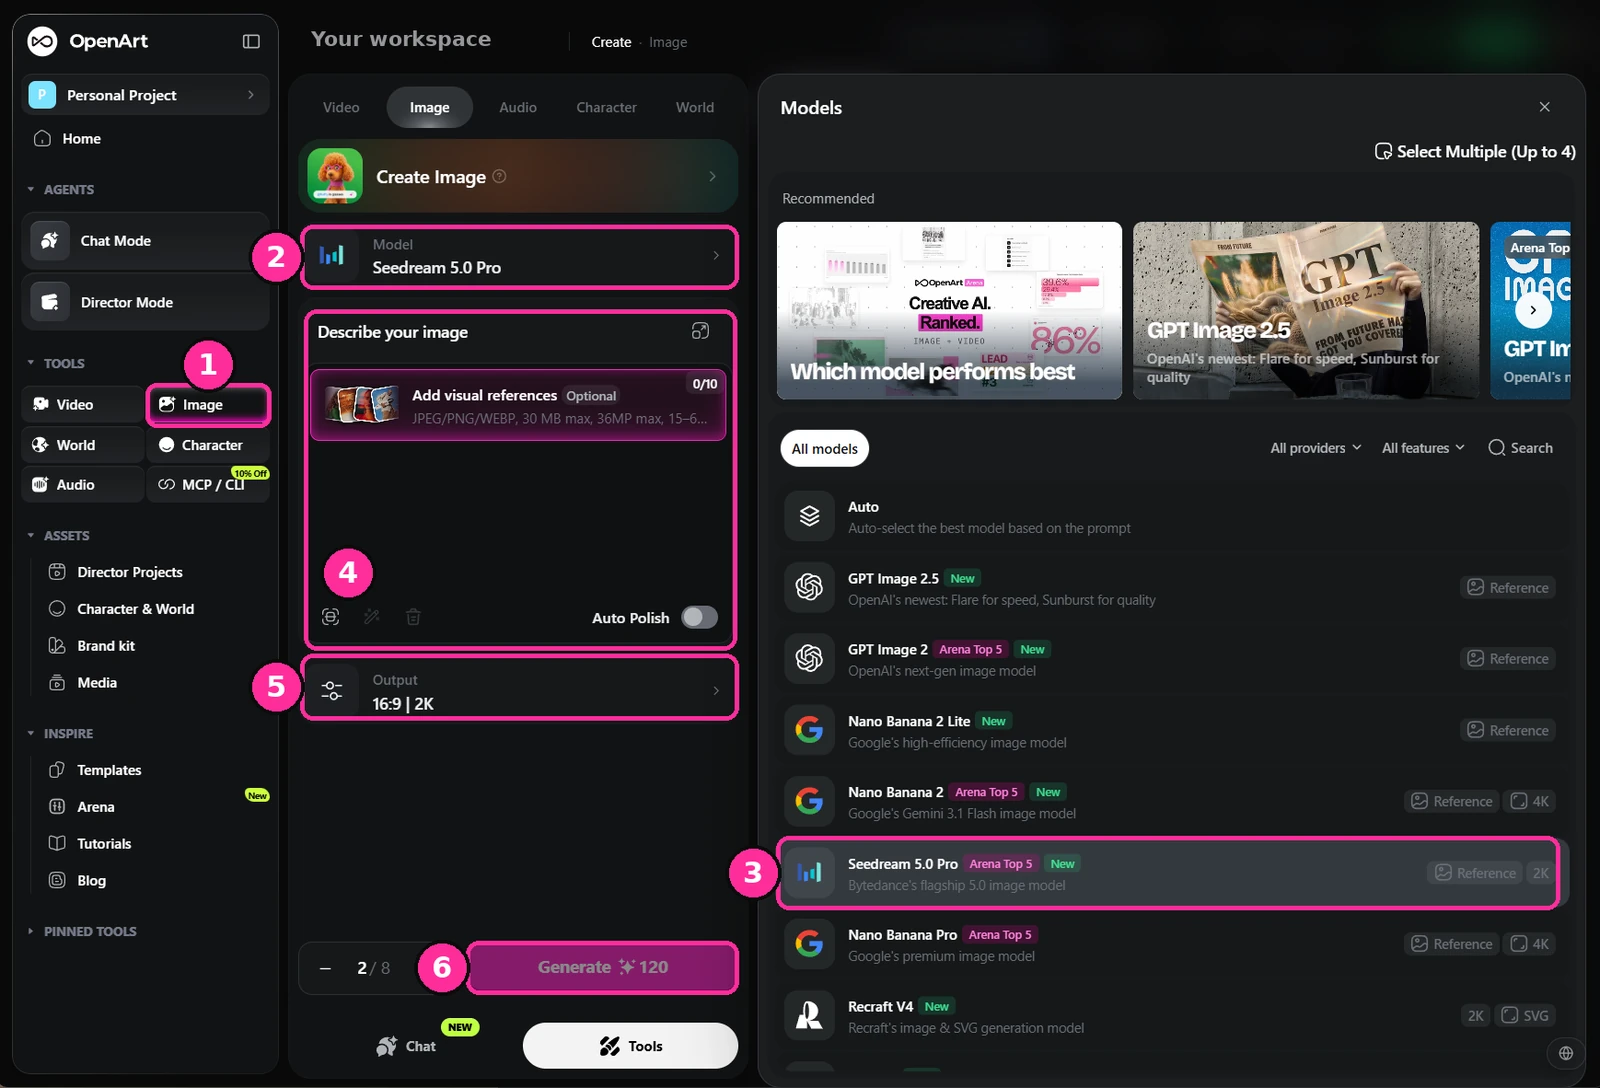
- 图像。从侧边栏选择图像工具。
- 模型。点击模型行以更改你正在使用的生成工具。
- Seedream 5.0 Pro。我用它制作场景和角色定妆照。GPT Image 2 也值得一试。
- 提示词。在这里写下场景描述。此阶段参考图像是可选的——你是在创造外观,而不是匹配某个现有图像。
- 输出。设置你的宽高比和分辨率。凡是最终会出现在屏幕上的内容,我都用 21:9 的 2K 制作。
- 生成。批量运行,而不是一张一张生成。你需要多个选项。
下面这个场景背后的提示词就是这样的结构。给各部分加上标签,这样你就能只改一处而不动其余部分。
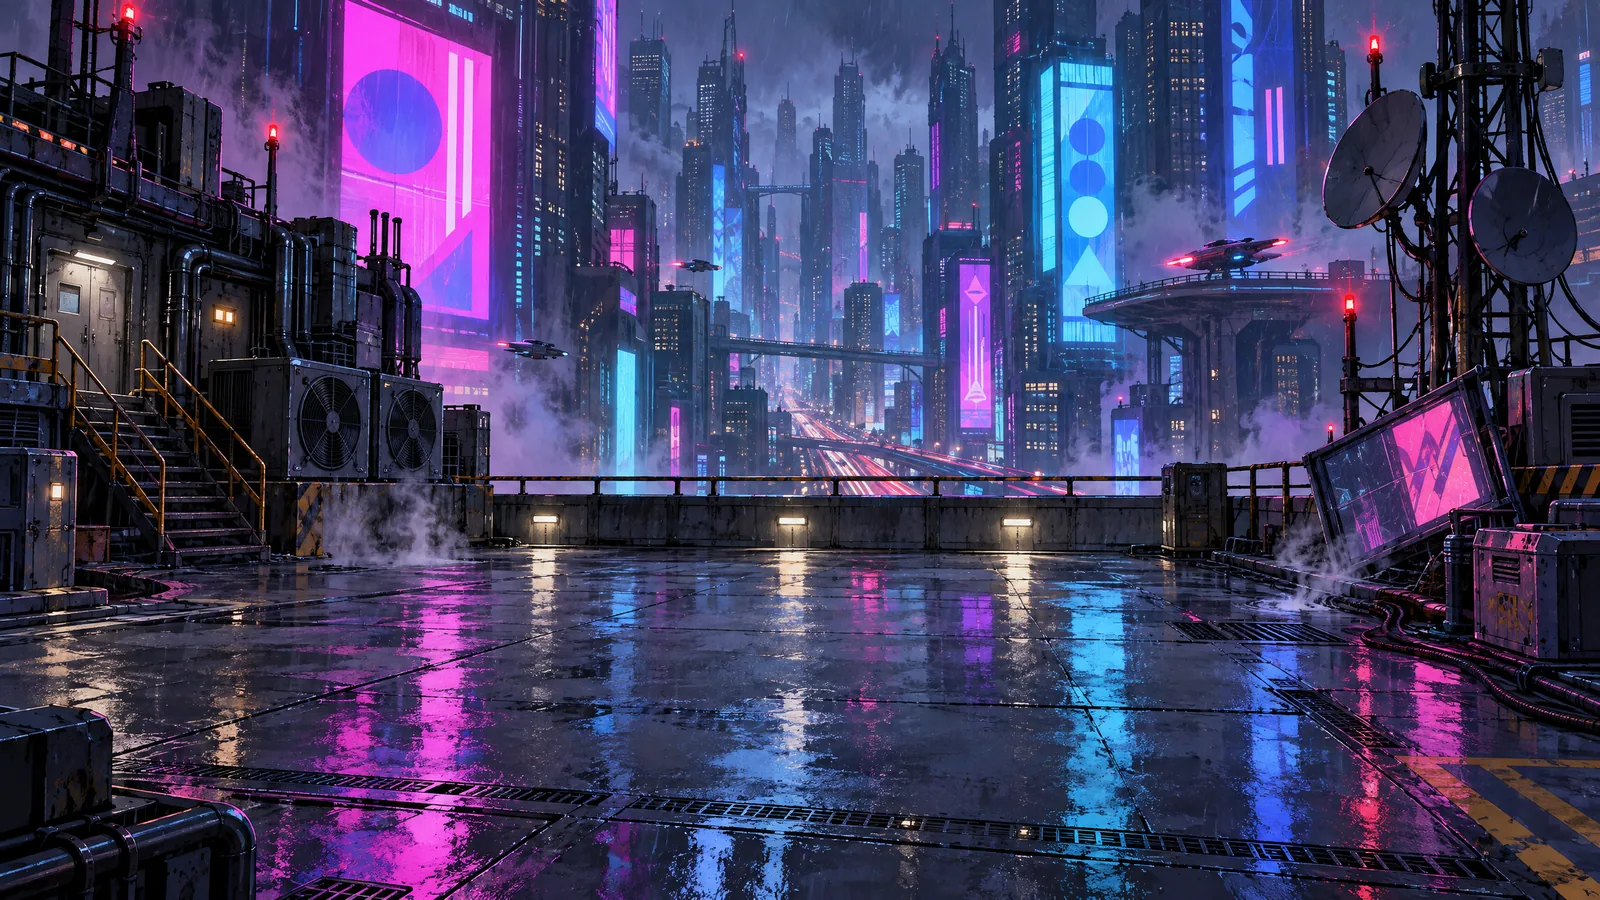
那就是整个场景后续搭建所依托的基础板。注意中间留出了多少空白——那个空间是刻意保留的。
如果你想在一个场景内部移动镜头,而不是生成平面静态图,场景搭建还有第二条路径。
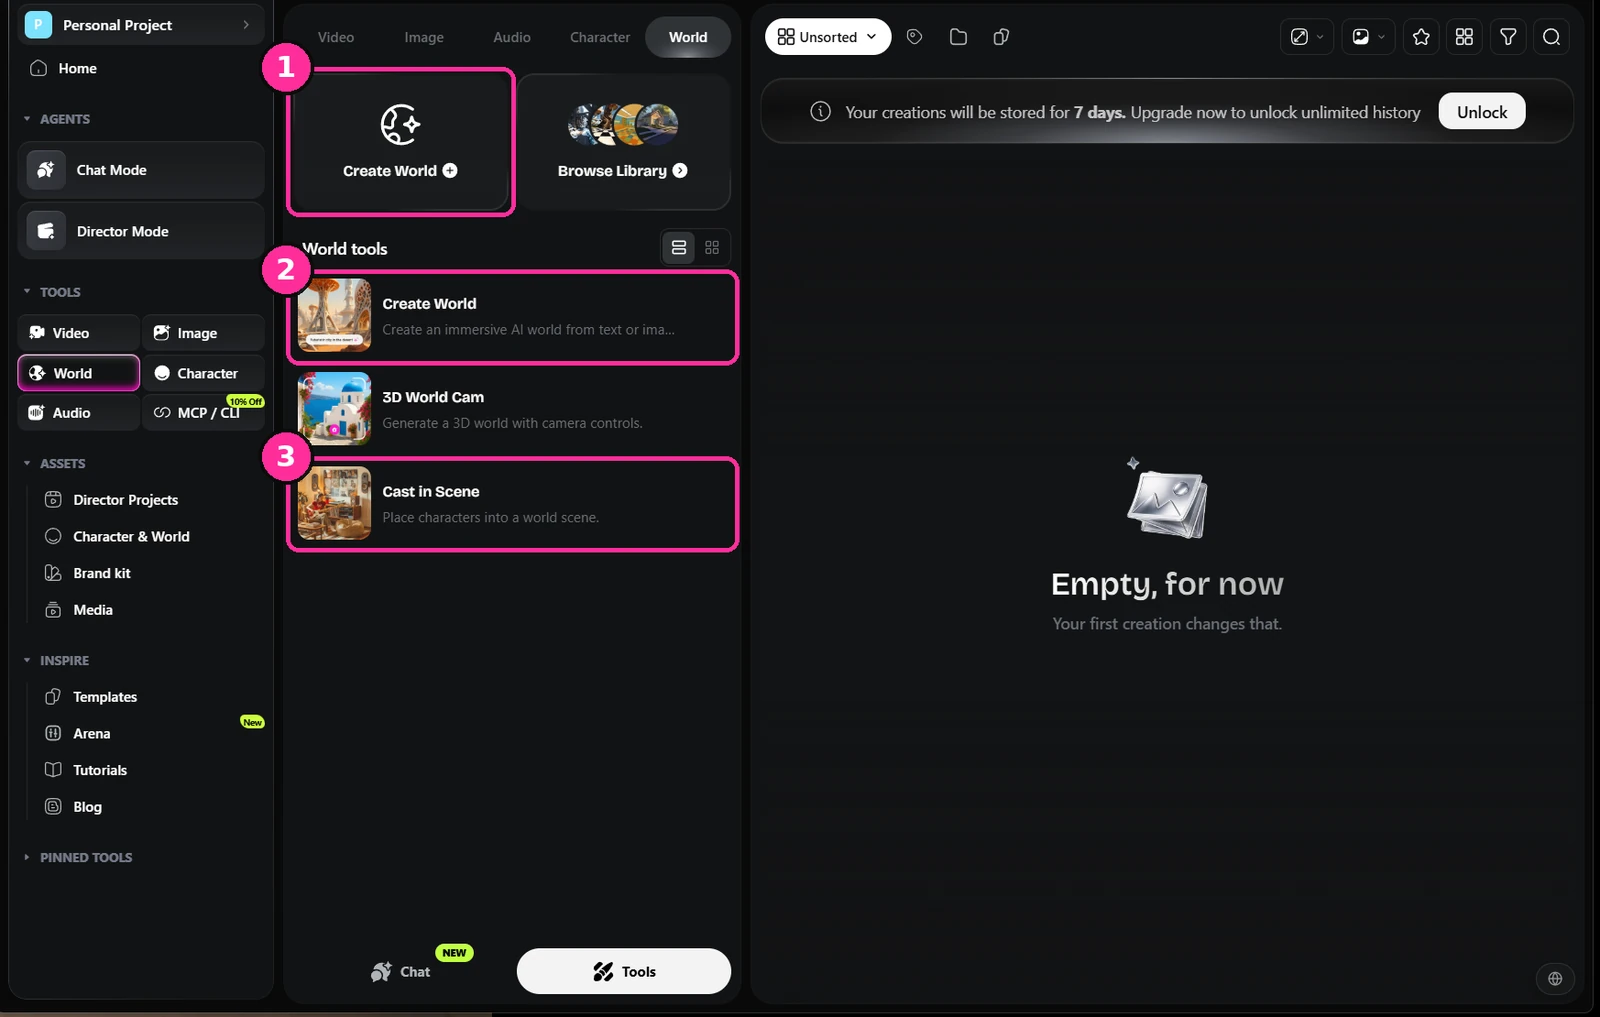
- Create World。构建一个可探索的 3D 环境,而不是单张图像。
- Create World 工具。可以从文本开始,也可以基于你已经生成的图像。
- Cast in Scene。将一个已锁定的角色放入你已经搭建好的世界中。
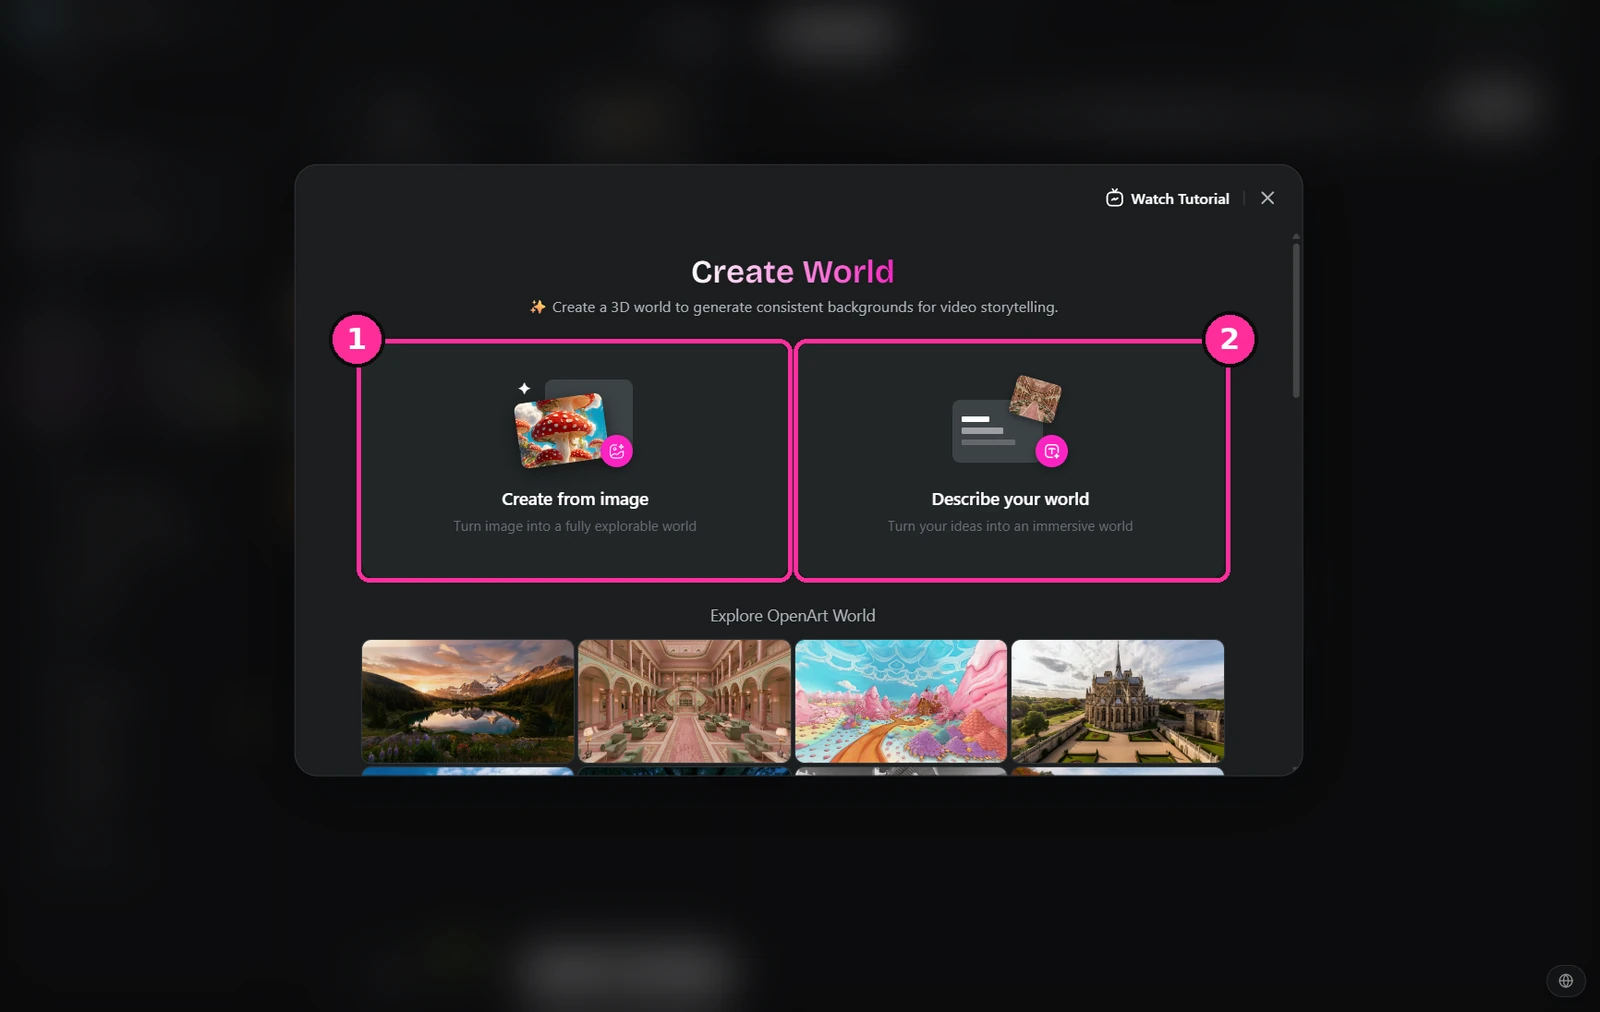
- Create from image。输入你已经批准的静态图,让世界与你的电影相匹配。
- Describe your world。如果你目前还什么都没有,可以从文本描述开始。
设计角色
同样的工具,同样的模型,同样的方法。描述体型、年龄、服装、发型、伤疤等一切细节——具体永远胜于诗意。在继续之前,先得到一张你真正满意的图像,因为之后的一切都会继承它。
不要在只有一半满意的面孔上继续推进。你会在整部电影中一直看着它。
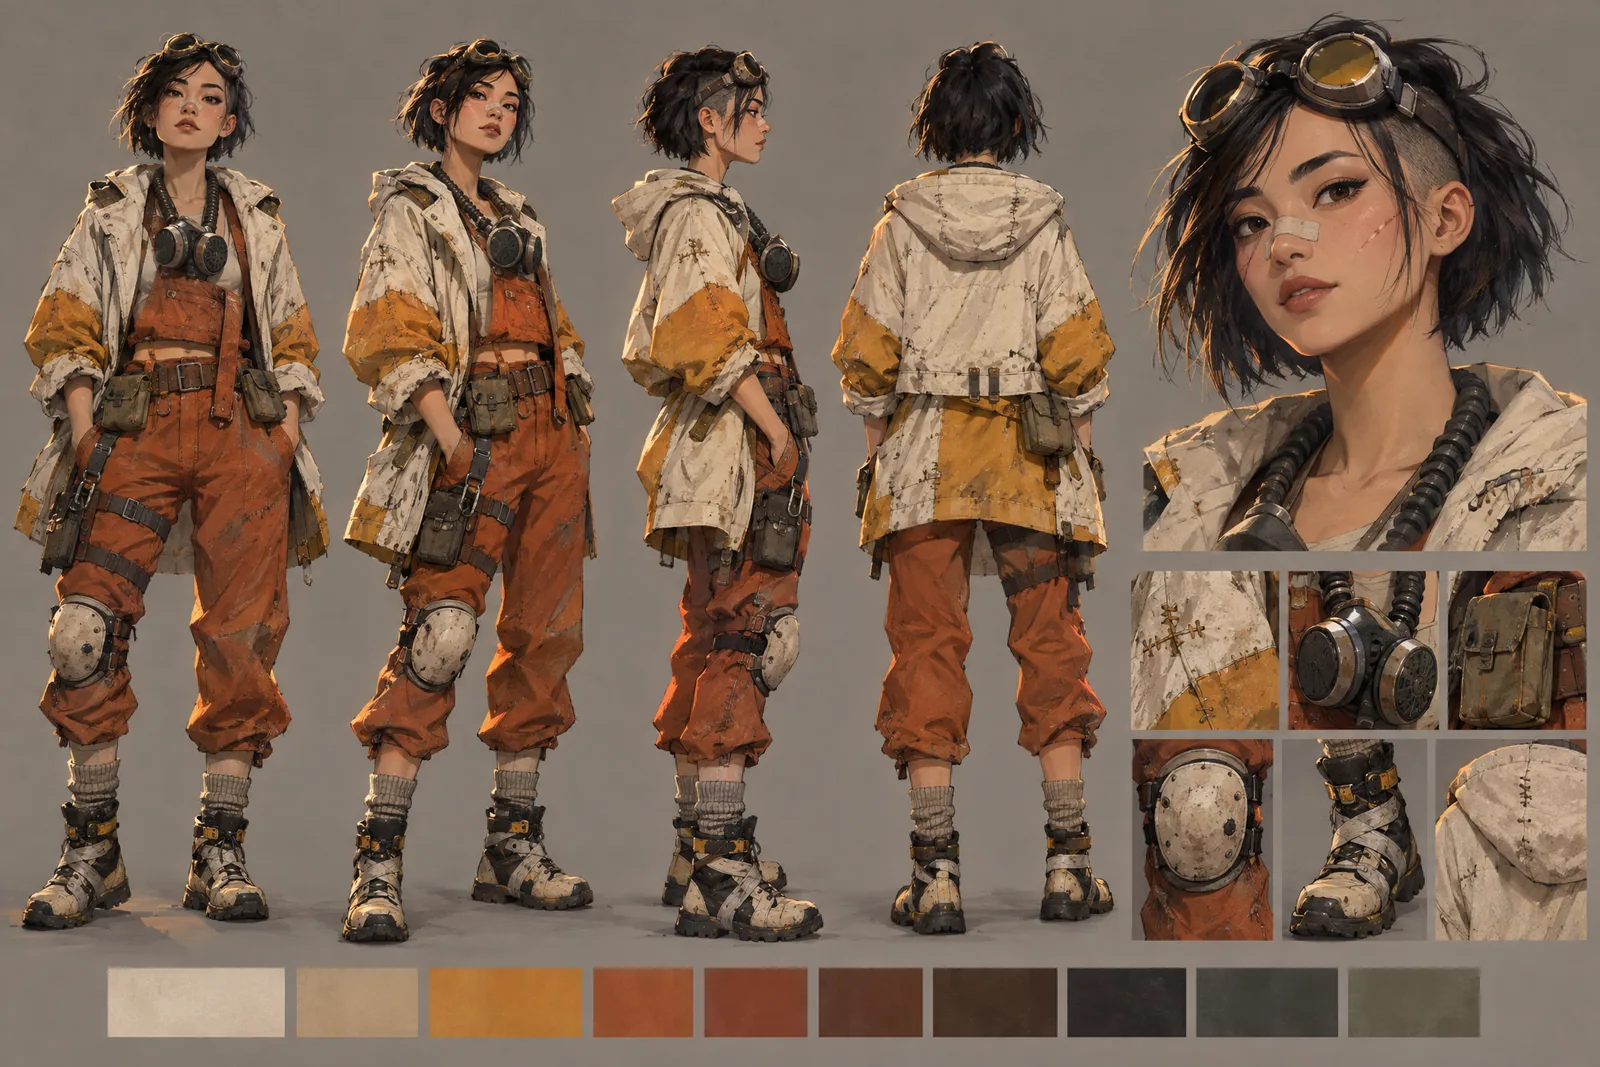
针对你已经搭建好的世界来设计他们。这个角色的装扮就是为了在那种霓虹灯光下显得协调。
锁定角色
这是大多数人会跳过的一步,却也是决定你的电影能否连贯统一的一步。从你的主角图出发,生成多个角度的头像和一个全身转身镜头,然后将其保存为角色以便重复使用。
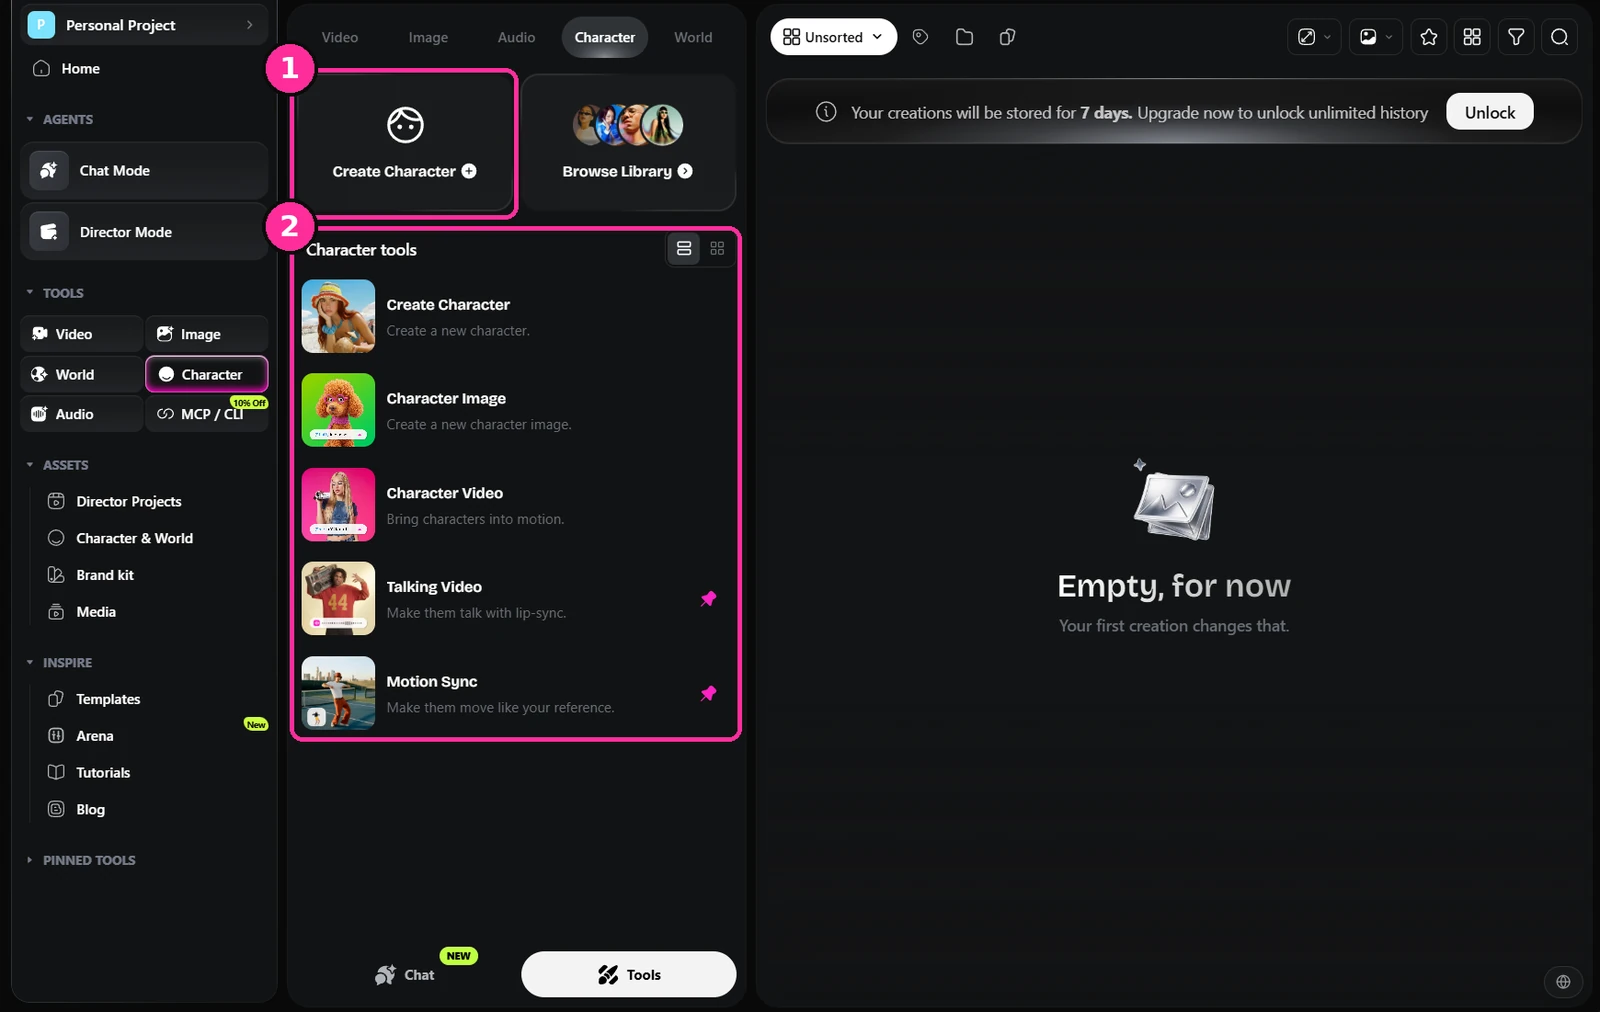
- Create Character。创建一个可重复使用的角色,而不是又一张一次性图像。
- 角色工具。创建、图像、视频、对话视频和动作同步都挂在同一个已保存角色之下。
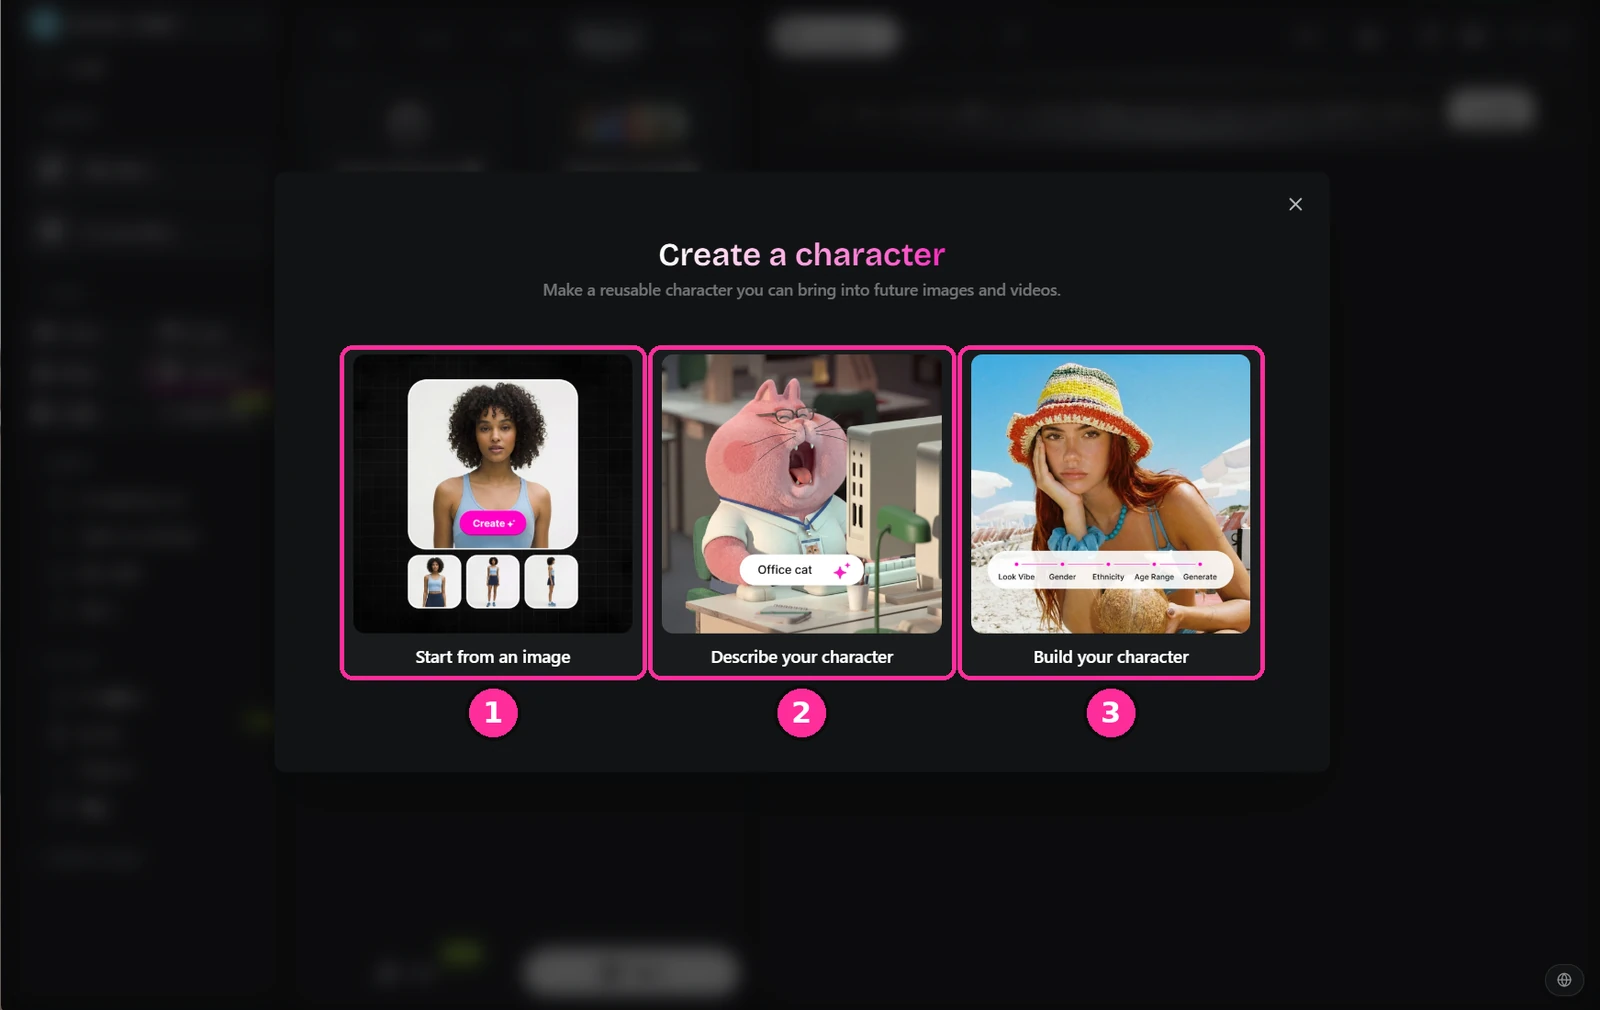
- 从图像开始。我使用的方式——输入你在第二步中批准的主角图像。
- Describe your character。如果你是从零开始,仅用文本描述。
- Build your character。提供关于外观、年龄等的引导式选项。
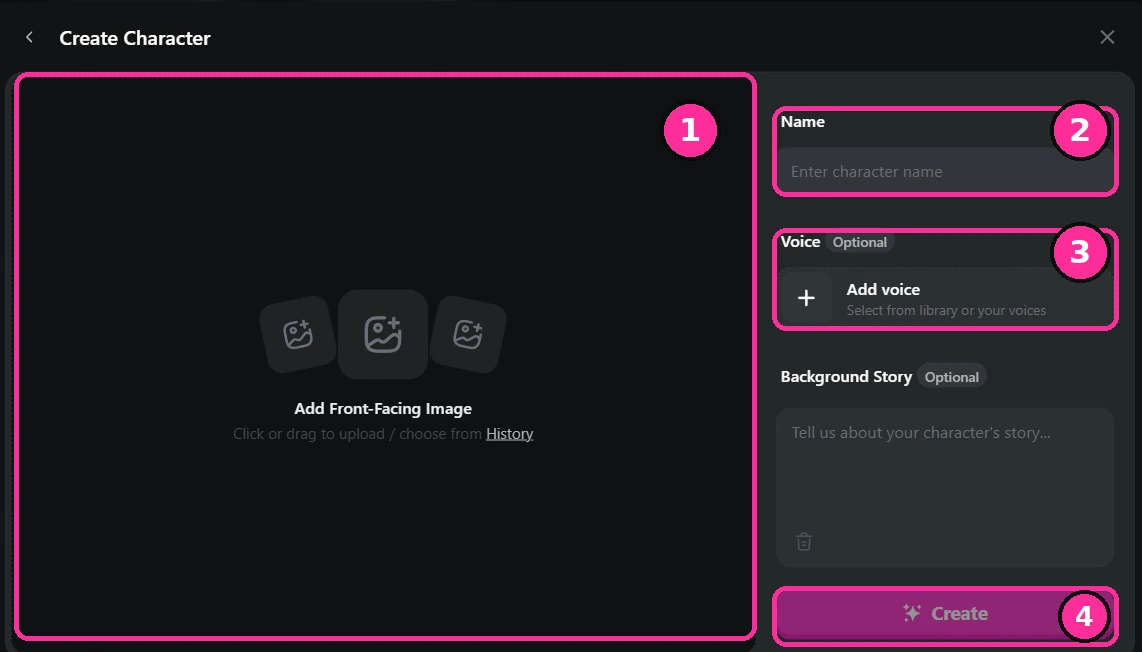
- 正面图像。上传已批准的主角静态图。正面、清晰、光线良好。
- 姓名。正式为他们命名。在后续的整个制作过程中,你都会从列表中选择他们。
- 声音。此处为可选项,但现在关联好可以省去之后每个镜头都要单独处理的麻烦。
- 创建。保存到你的素材库中,可供每个工具使用。
角色设定表的提示词写法与场景相同,先说明版面布局,让模型将各个画格放在你想要的位置。
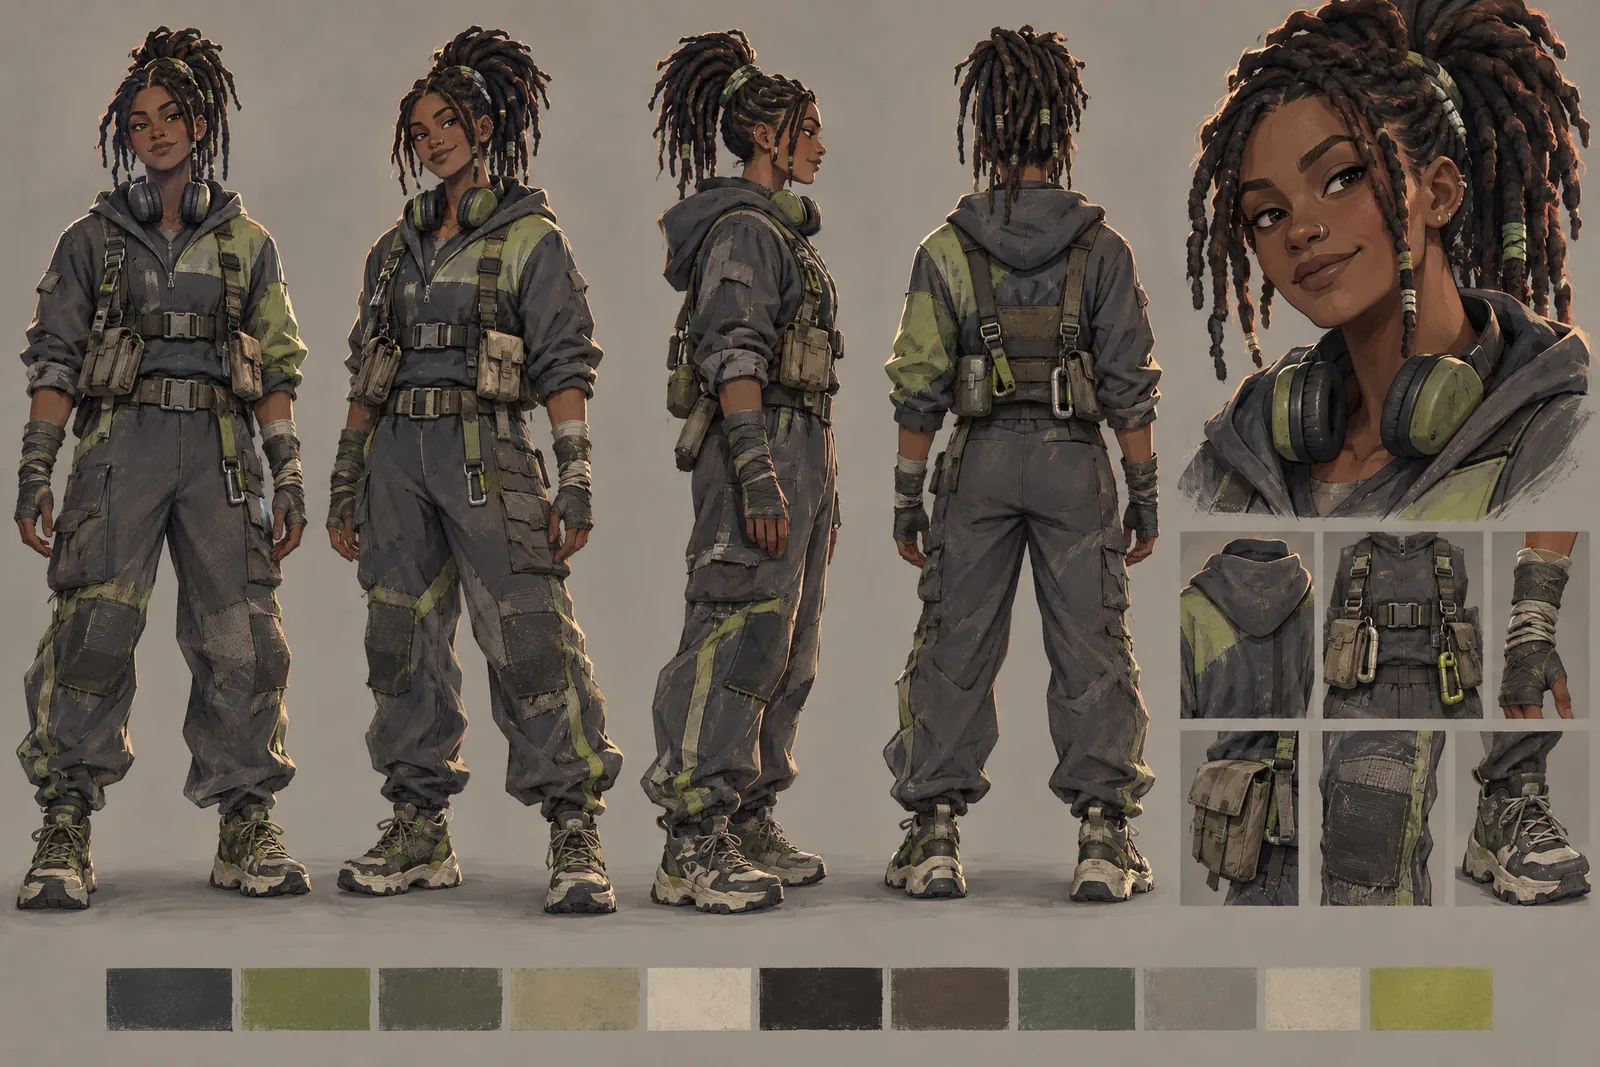
那一整套图就是你的角色。在角色出现的每个镜头中,都把它作为参考图重新提供,这样角色在剪辑之间就不会再产生偏差。
撰写场次,然后附加素材
现在写下发生的事情。用平实的语言描述动作和表演——他们做了什么、如何移动、感受如何——然后将你的场景和角色参考图附加到提示词中,让模型基于你已经批准的内容进行构建,而不是凭空创造新的东西。
生成镜头
将已批准的画面带入视频制作。按镜头逐个进行,而不是按场次进行,并预期一个提示词需要运行多次才能成功一次。可用率很低。这是正常的,而且仍然比雇佣一个摄制组更快。
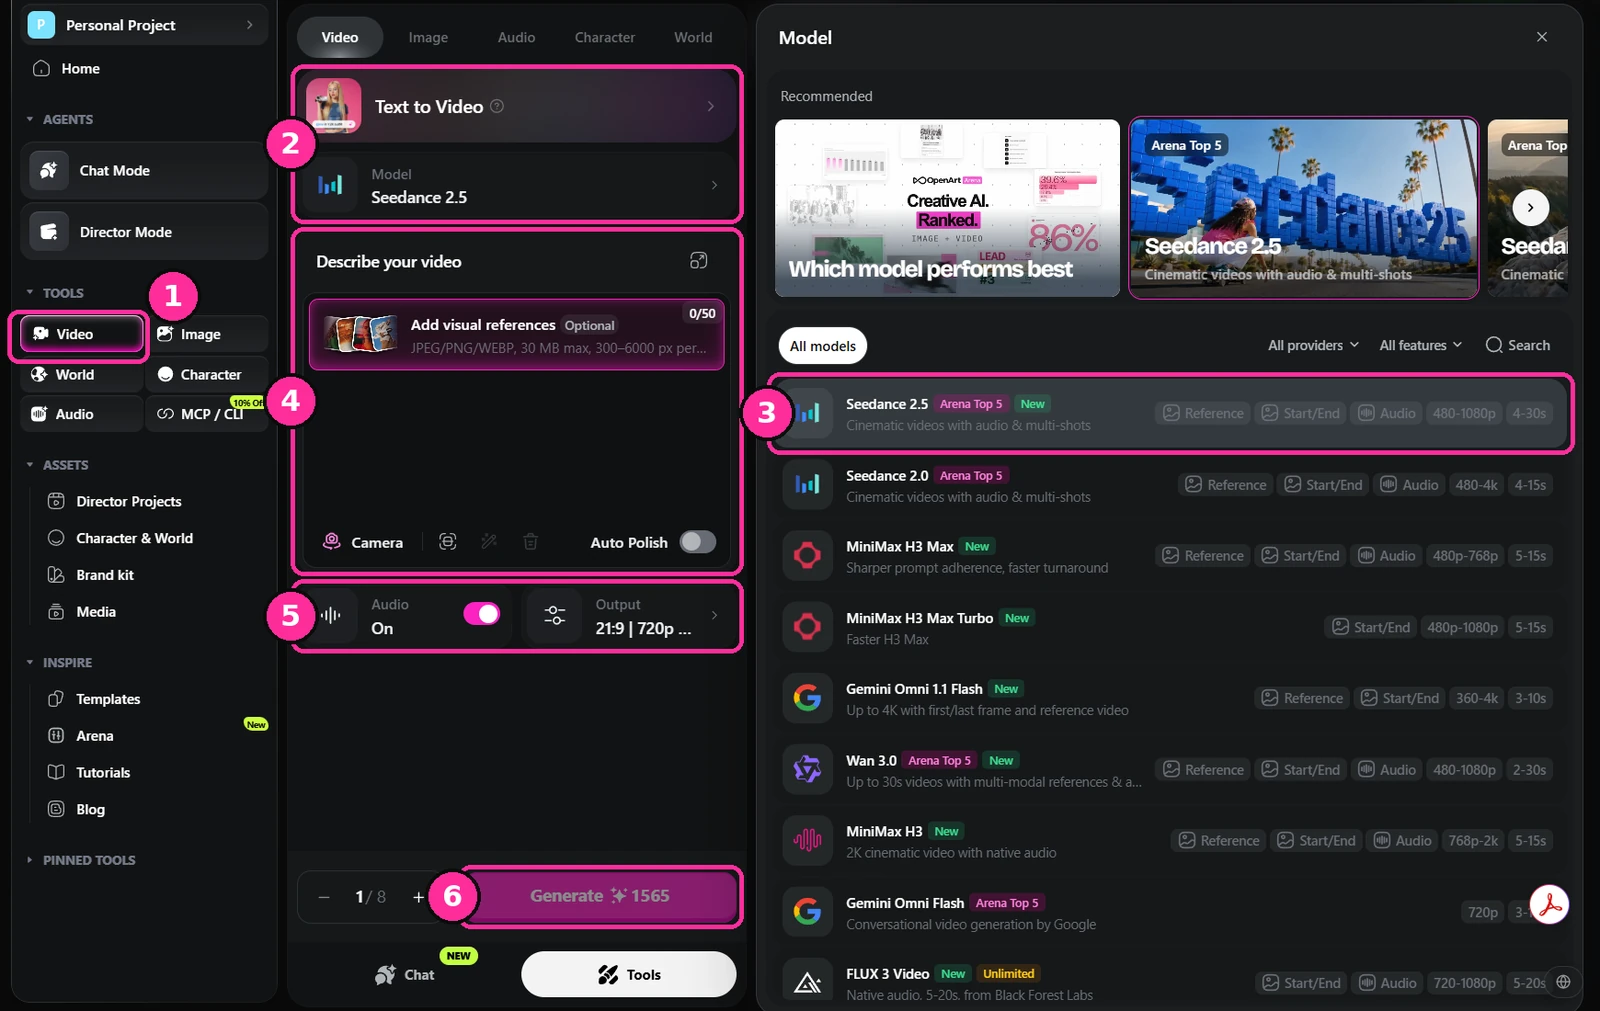
- 视频。切换到视频工具。
- 模式与模型。如果从零开始就用文本转视频,如果是让已批准的静态图动起来就用图像转视频——而现在你应该已经做到这一步了。
- 模型列表。每个模型都会显示它支持的功能:参考图像、起始与结束帧、原生音频、分辨率和片段时长。根据你真正需要的功能来选择。
- 提示词与参考图像。你的场次描述,附带角色和场景参考图。
- 音频与输出。开启或关闭原生音频,以及宽高比和分辨率设置。
- 生成。提交前请注意积分消耗。视频正是消耗积分最多的地方。
配音与音乐
两者都位于音频工具中,所以你永远不必离开平台就能为场次配乐。配音使用 ElevenLabs——你可以从声库中选择、根据描述设计一个新声音,或克隆你自己的声音。
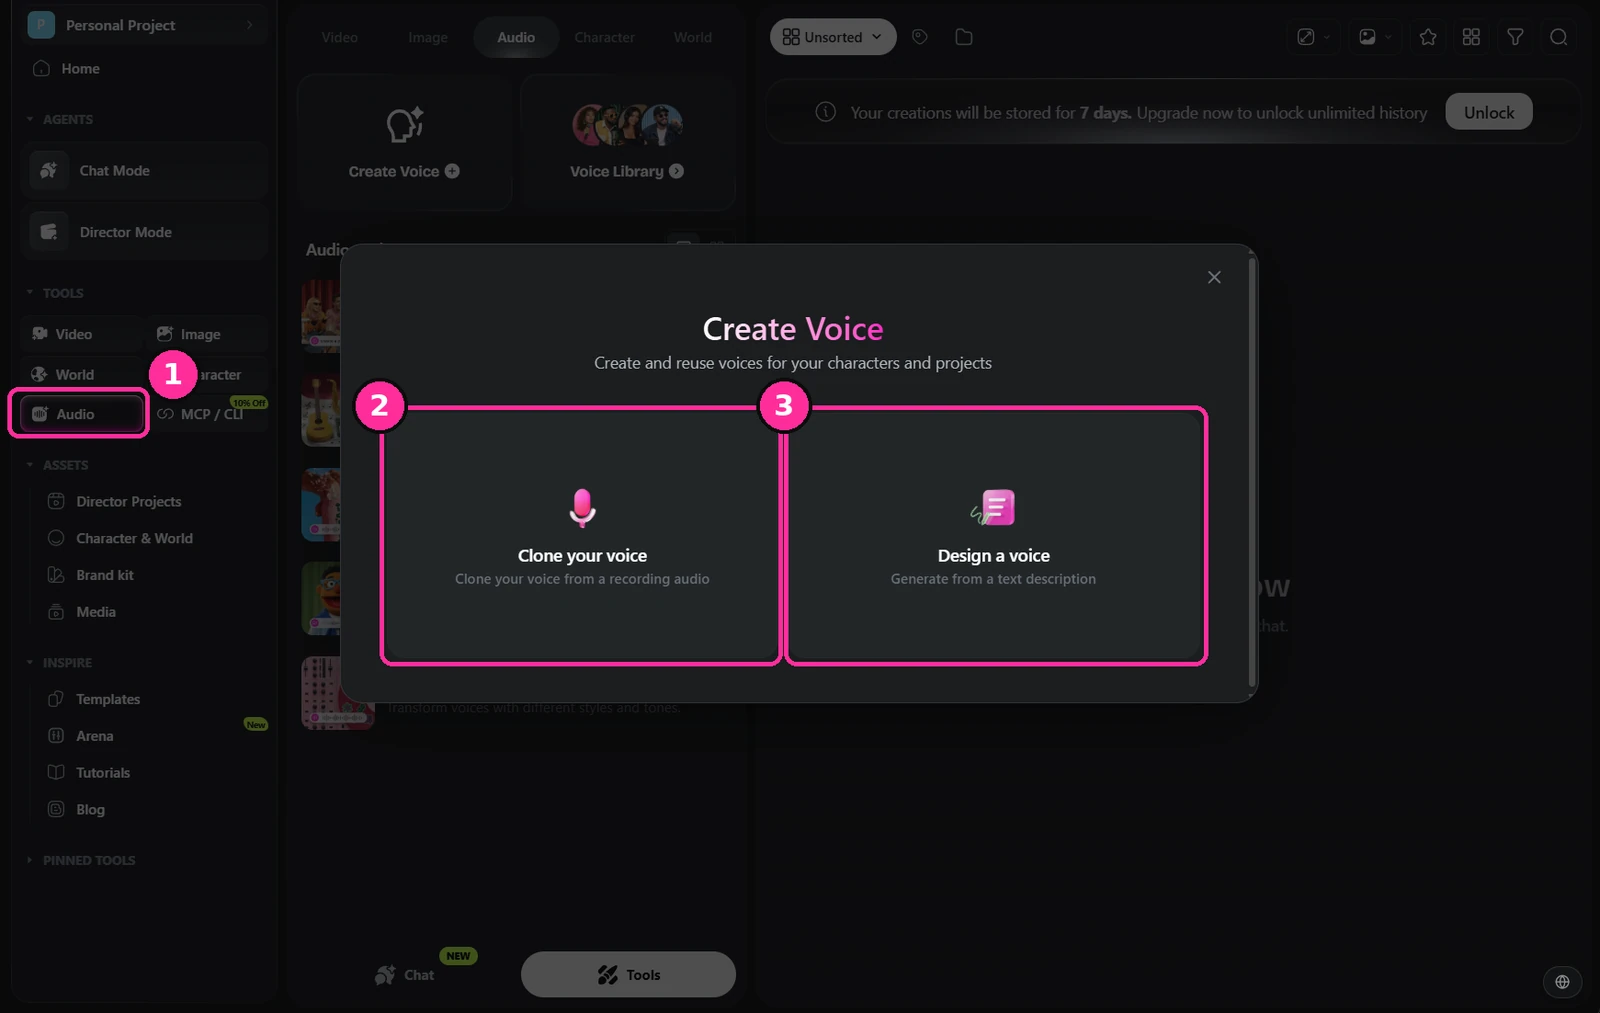
- 音频。侧边栏中的音频工具。
- Clone your voice。如果你要亲自配音,可以基于一段录音进行克隆。
- Design a voice。根据文字描述生成,适合为一组角色打造声音。
音乐位于同一位置,在 Create Music 下。
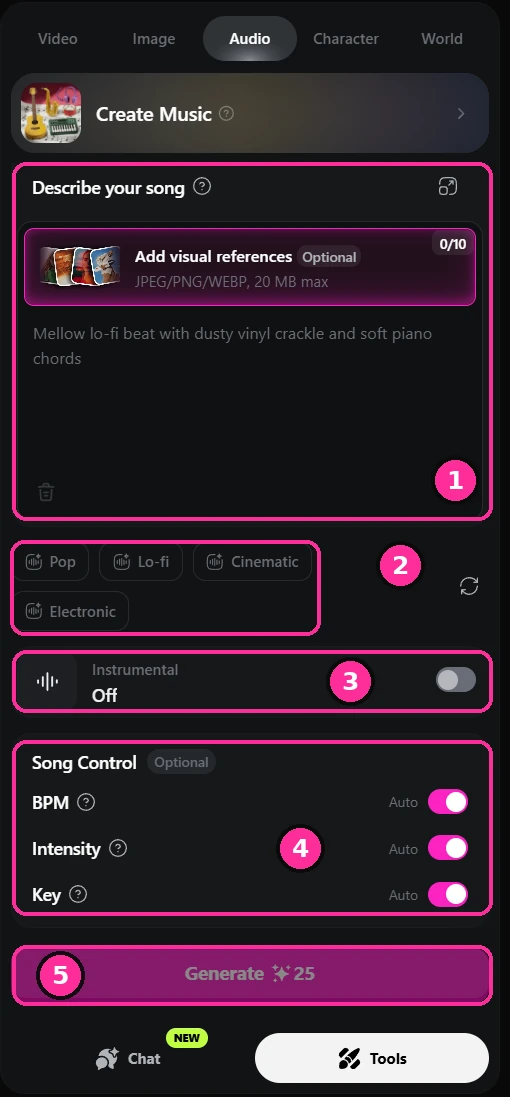
- Describe your song。像给作曲家写简报一样撰写:情绪、乐器、质感。你可以附加静态图,让曲目根据画面内容进行创作。
- 曲风。如果你不想从零开始撰写,这里提供快速起点。
- 纯音乐。为配乐打开此项。你几乎从不希望在对白下方出现人声。
- 歌曲控制。BPM、强度和调性,除非你需要命中特定要求,否则均设为自动。
- 生成。比视频便宜得多,所以可以多生成几个再挑选。
剪辑、调色、交付
这部分工作在 OpenArt 之外完成。将你的片段、配音和音乐导入合适的剪辑软件,在那里完成剪辑。如果想要快速简单可以用 CapCut,如果想要更精细的控制可以用 Premiere Pro 或 DaVinci Resolve。CapCut 和 Resolve 都有免费版本,完全足够完成一部电影。
电影是在剪辑中完成的,一直以来都是如此。节奏、声音设计和配乐对一个场次的作用,远超再来一轮生成。最后再进行调色,让一切呈现在同一个世界里。
排查你的生成结果
当视频没有按你想象的样子出来时,不要气馁。一个镜头第一次就成功的次数,我用一只手就能数得过来,而我做这行已经有一段时间了。
这项工作的关键不是不断按下生成键并抱有期待。看看返回的结果,找出真正导致不想要的效果的原因,然后回到提示词进行调整。可能是一个词,也可能是整整一行,也可能是完全缺失了什么,模型代替你自行补上了空白。
每次只改动一处,这样你才知道是什么造成了变化。提示词中的一个词就可能让结果完全不同——这在两个方向上都成立,而当你多次体会到这一点之后,你就会不再重写整个提示词,转而做出一次有意为之的改动。
镜头完全不动。它停留在参考图像原本所在的位置,导致两个角色都显得又小又远,打斗场面呈现为两个你看不清的剪影。
力量特效画面也失控——画面被绿色淹没,在十秒钟的镜头中持续了三秒以上。色彩爆闪应该是一个标点符号,而不是整场戏。
相同的场次、相同的角色、相同的参考图像。这一次镜头独立于底板移动——绕到她的肩后,顺着手臂而下,掠过子弹,转向另一张脸。
绿色特效只持续四分之一秒,拳头也只命中一次。让第一次尝试看不清的一切,都是提示词的问题,而不是模型的问题。
这还不是一个完成的镜头,以目前的状态我也不会把它剪进场次里。但它已经足够成熟,可以继续打磨——而这正是在这个阶段对一次尝试的全部要求。
下一轮修改会把它拆开来处理。目前拳头是在一个连续动作中完成的。我会剪成她直冲镜头出拳,这比从侧面观看更有冲击力,然后再剪到命中的瞬间以及她后退的动作。空间感是另一个要点——你应该清楚地知道两人在镜头的每一刻相对彼此的位置,而在动作进行到中段时,这种空间感被丢失了。
这两次尝试都来自同一次会话,相隔仅几分钟,使用相同的设置。
常见问题
你用哪些工具制作 AI 电影?
图像方面我使用 GPT Image 2 和 GPT Image 2.5、Seedream 5.0 Pro 以及 Nano Banana Pro。具体选用哪个取决于镜头需求。
视频方面我只使用 Seedance 2.5,没有其他。
以上是模型。我运行它们的平台是 OpenArt,它将图像模型和视频模型集中在一处,并共用相同的参考图像,这样我就不需要在四个不同的网站之间搬运文件来完成一个镜头。
你如何防止 AI 角色在镜头之间发生变化?
在拍摄任何内容之前,你要先锁定角色。生成一张你满意的主角图像,然后用它构建一套参考素材:多个角度的头像和一个纯色背景下的全身转身镜头。
角色出现的每一个镜头都会附加这套素材。如果没有它,模型每次生成都会重新构想这张脸,结果没有任何一个镜头能剪在一起。
制作 AI 电影需要高性能电脑吗?
不需要。模型运行在平台的服务器上,而不是你的设备上,所以你只需要一个网页浏览器和一个良好的网络连接。不需要安装任何东西,也没有任何本地渲染。
唯一会用到你自己硬件的部分是最后的剪辑,而 CapCut 或 DaVinci Resolve 在普通笔记本电脑上就能运行。
制作一部 AI 电影要花多少钱?
没有一个诚实的确切数字,任何给你一个具体数字的人都只是在猜测。它会因你选择的模型、分辨率、片段长度而变化——更重要的是,取决于一个镜头需要尝试多少次才能成功。
它按每次生成的积分计价,不论结果是否可用都要收费。请为一个镜头准备多次尝试的预算,而不是只做一次。
唯一能可靠压低费用的办法是:先在低分辨率下测试提示词,只有在确定要保留的那次尝试上才升级到完整分辨率。
一段 AI 视频片段能有多长?
我用的 Seedance 2.5 一次可以生成 4 到 30 秒。大多数其他模型更短,所以在确定镜头长度之前先确认一下上限。
这个数字指的是你在一次生成中能获得的连续镜头长度,而不是你的电影总时长。成片仍然需要在剪辑软件中逐个镜头进行组装,与其他电影别无二致。
镜头生成完成后,电影就算完成了吗?
还没有。模型输出的是原始素材——单独的镜头,没有顺序,没有节奏,也没有声音设计。这更接近拍摄日结束时你手上会有的东西,而不是一部电影。
电影是在之后于剪辑软件中制作完成的:挑选要使用的镜次、将它们剪接在一起、把控节拍时机、加入音乐和声音,并对一切进行调色,使其呈现在同一个世界里。
这一部分完全没有改变,也正是它决定了成品是感觉像一部电影,还是像一段作品集展示。CapCut 和 DaVinci Resolve 都有免费版本,能完成其中的每一个环节。
可以把 AI 电影发布到 YouTube 上吗?
可以,AI 电影是被允许的。YouTube 的要求是,当内容逼真到观众可能误以为真实时,你需要进行披露。这是上传流程中的一个开关,位于已更改或合成内容选项下。
让频道陷入麻烦的,是大规模生产、重复性的上传内容,而其中没有任何原创性——问题不在于 AI 本身。
这些规则会不断变化,所以请查阅 YouTube 官方页面,而不是把我说的话当作最新依据:披露已更改或合成内容的使用情况。
为什么模型会忽略我提示词的一部分?
因为模型会选择最短、最简单的路径来生成符合你要求的内容。如果你把某部分留得模糊不清,模型就会替你做决定,而它做出的决定永远是最容易生成的那个。镜头保持不动。角色留在原地。困难的事情会悄无声息地不发生。
所以你必须强迫它走更难的那条路。对你真正在意的事情要明确表述,不要给它留下用更简单方式替代的空间。
当某些内容被忽略时,每次只改动一处并重新生成,这样你才能知道是哪个词造成的。重写整个提示词并不会告诉你任何有用信息。
这就是目前大部分的技艺所在。我预计这会变得更容易,但眼下你确实需要真正推动它去完成较难的那个版本。
目前哪些 AI 模型实际上是最好的?
这取决于谁在评判,以及评判的用途。我关注的是 OpenArt Arena,因为它由从业导演和艺术家进行盲评,而不是公开投票,而且是按工作类型分类的——影视、广告、动画、动效设计、口型同步、电商、平面设计。在广告类别获胜的模型未必就是你想要的电影模型。
影视类排行榜才是这里最重要的。本页顶部的这一栏,就是从他们的排行榜中提取的当前影视视频和影视图像前三名的实时快照,因此展示的是今天为真的情况,而非我写这篇文章时为真的情况。
有一点提醒比排名本身更重要:排行榜的榜首并不等同于适合你镜头的模型。我在所有视频工作中都使用 Seedance 2.5,是因为它处理参考图像的方式以及单个片段能持续的时长,而不是因为它在某个排行榜上的位置。
J2 industries 与 OpenArt 存在商业合作关系,本页面的链接可能带来佣金收入。上述工作流程正是我们自己制作过程中所使用的方式。