如何製作一部 AI 電影
持續關注最佳 AI 模型
影片模型
- 1Seedance 2.5ByteDance
- 2Seedance 2.0ByteDance
- 3Wan 3.0Alibaba
圖像模型
- 1Seedream 5.0 ProByteDance
- 2Nano Banana ProGoogle
- 3GPT Image 2OpenAI
由 OpenArt Arena 針對影視用途進行排名,評審團由業界導演和藝術家組成盲評小組。資料截取時間為 15 September 2026。完整詳情見下方問題解答。
J2 industries 的電影就是這樣做出來的。沒有祕密提示詞,沒有魔法設定,只有一套行之有效的流程。先搭建世界,再鎖定角色,然後才開始拍攝。這一切都在 OpenArt 裡完成。
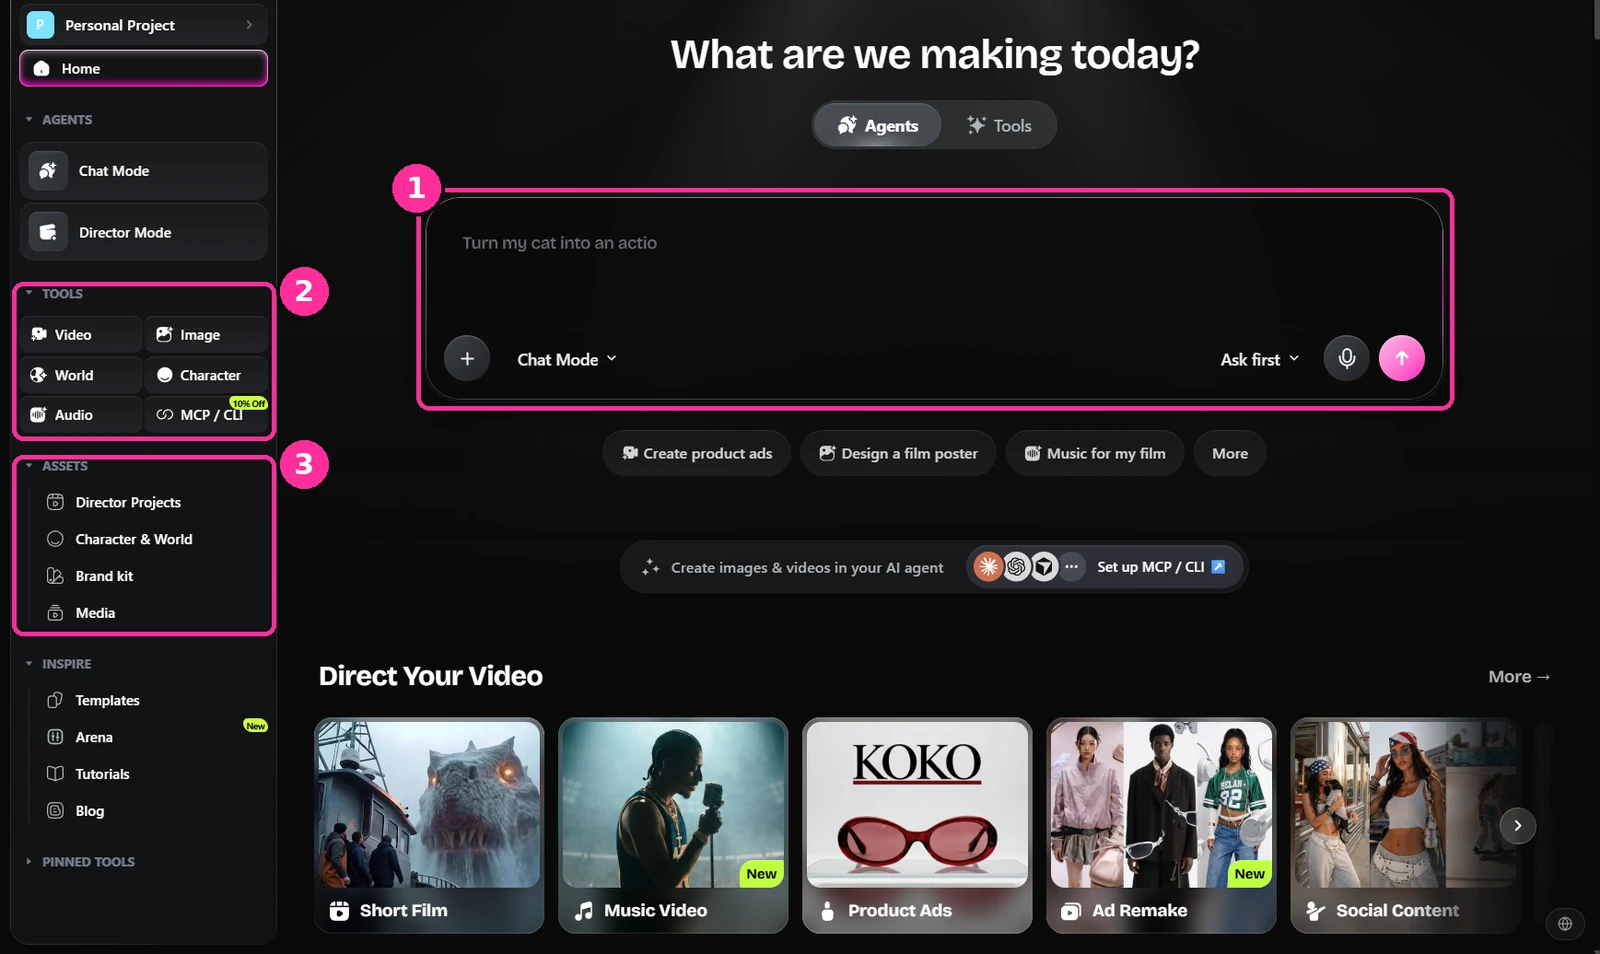
- 提示詞輸入框。一切從這裡開始。你可以在聊天中以對話方式操作,也可以直接進入某個特定工具。
- 工具。影片、圖像、世界、角色和音訊。這是你將長期使用的清單。
- 素材庫。你保存的角色、世界和媒體檔案。你在第三步鎖定的任何內容都會保存到這裡並可重複使用。
搭建場景
從地點開始,而不是鏡頭。用 Seedream 5.0 Pro 或 GPT Image 2 生成你的環境,並像場景勘察員一樣描述它:建築風格、時間、天氣、光線。此時先不用考慮鏡頭。
在你還處於這個場景時,生成同一地點的多個角度。你之後會用到它們,而一起生成能保持一致性。
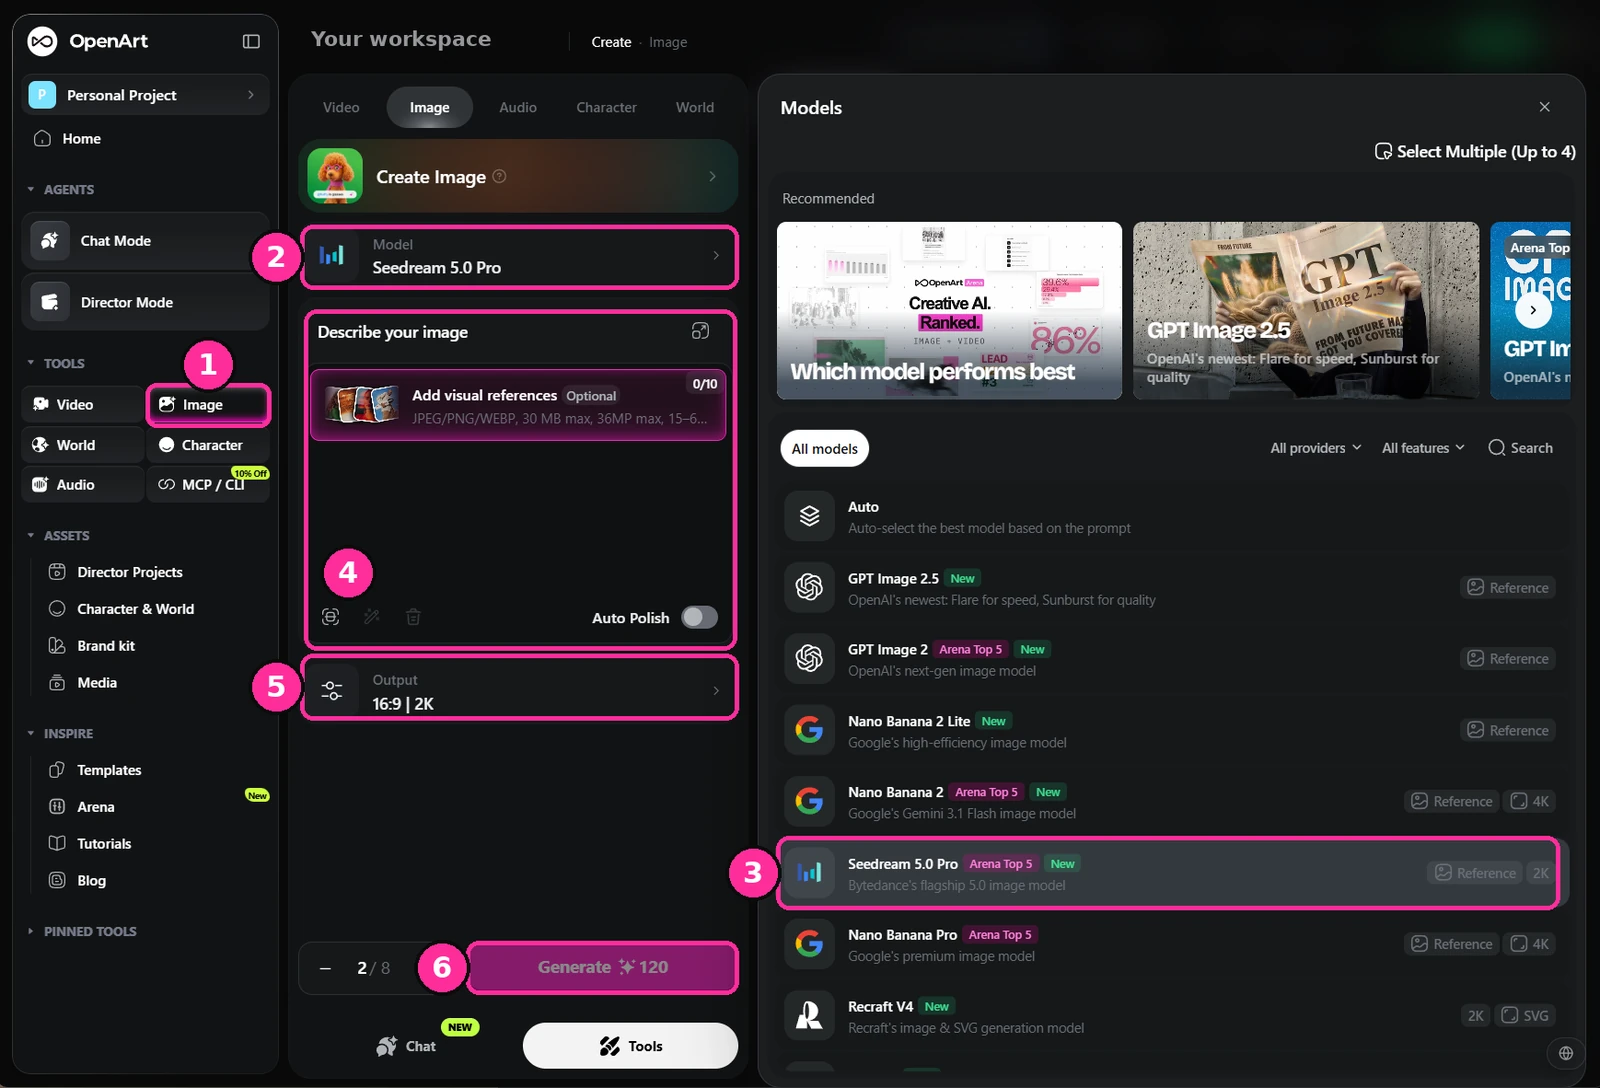
- 圖像。從側邊欄選擇圖像工具。
- 模型。點擊模型列以更改你正在使用的生成工具。
- Seedream 5.0 Pro。我用它製作場景和角色定妝照。GPT Image 2 也值得一試。
- 提示詞。在這裡寫下場景描述。此階段參考圖像是可選的——你是在創造外觀,而不是匹配某個現有圖像。
- 輸出。設定你的寬高比和解析度。凡是最終會出現在螢幕上的內容,我都用 21:9 的 2K 製作。
- 生成。批次運行,而不是一張一張生成。你需要多個選項。
下面這個場景背後的提示詞就是這樣的結構。給各部分加上標籤,這樣你就能只改一處而不動其餘部分。
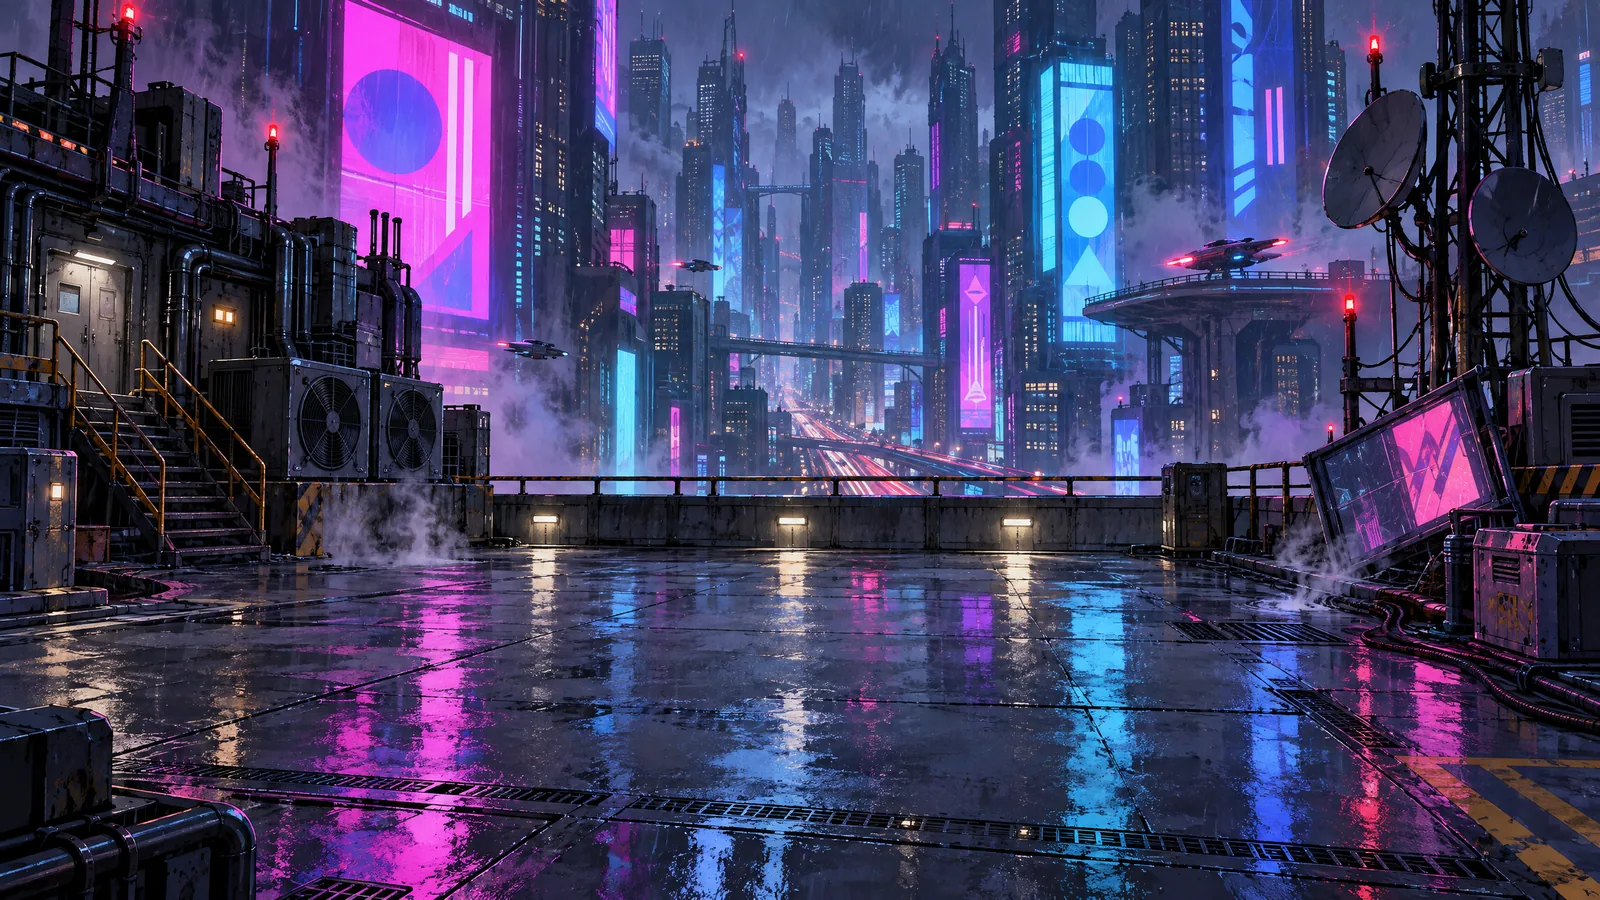
那就是整個場景後續搭建所依託的基礎板。注意中間留出了多少空白——那個空間是刻意保留的。
如果你想在一個場景內部移動鏡頭,而不是生成平面靜態圖,場景搭建還有第二條路徑。
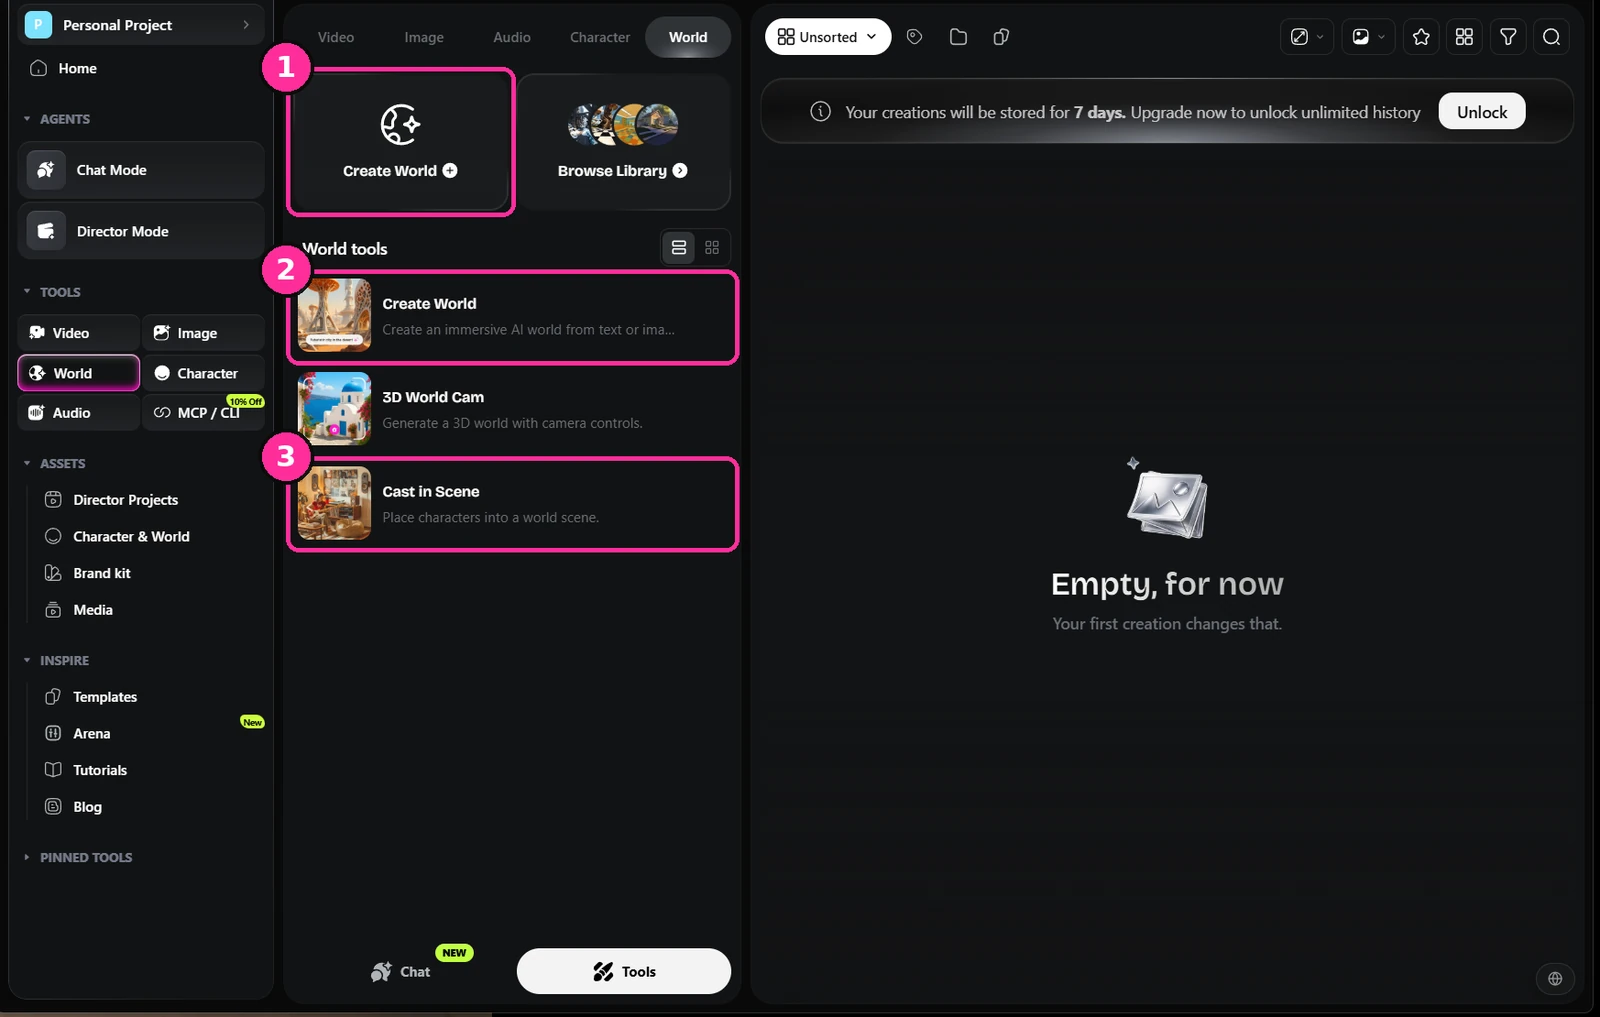
- Create World。構建一個可探索的 3D 環境,而不是單張圖像。
- Create World 工具。可以從文字開始,也可以基於你已經生成的圖像。
- Cast in Scene。將一個已鎖定的角色放入你已經搭建好的世界中。
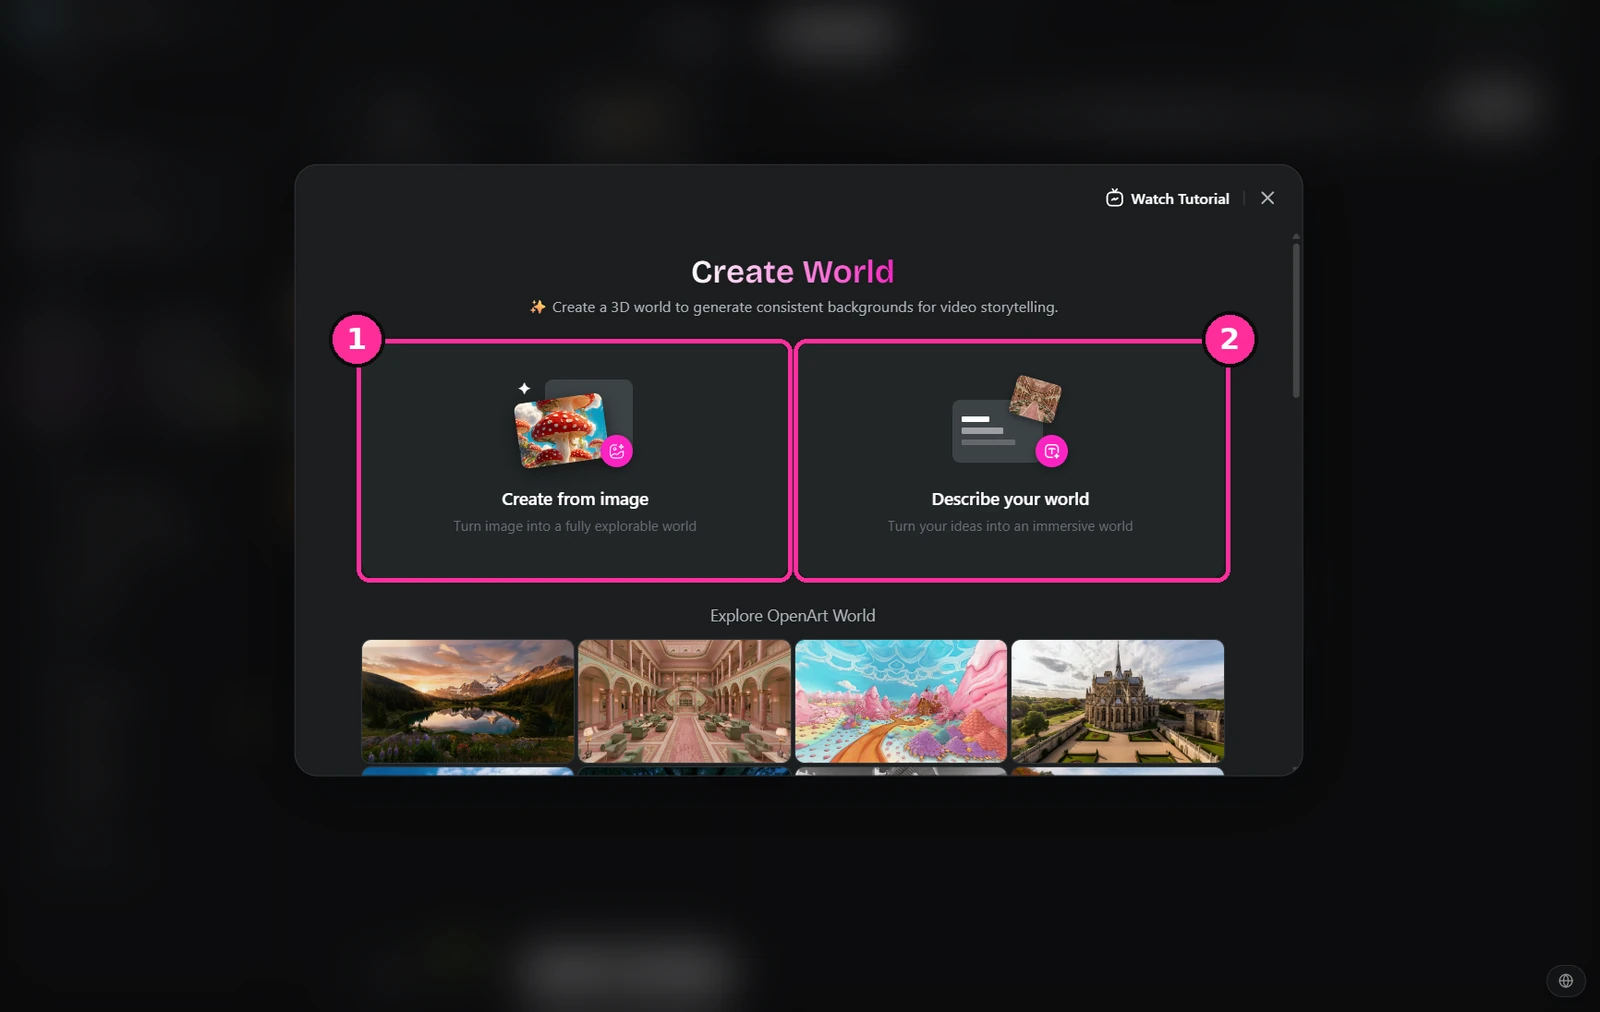
- Create from image。輸入你已經批准的靜態圖,讓世界與你的電影相匹配。
- Describe your world。如果你目前還什麼都沒有,可以從文字描述開始。
設計角色
同樣的工具,同樣的模型,同樣的方法。描述體型、年齡、服裝、髮型、傷疤等一切細節——具體永遠勝於詩意。在繼續之前,先得到一張你真正滿意的圖像,因為之後的一切都會繼承它。
不要在只有一半滿意的面孔上繼續推進。你會在整部電影中一直看著它。
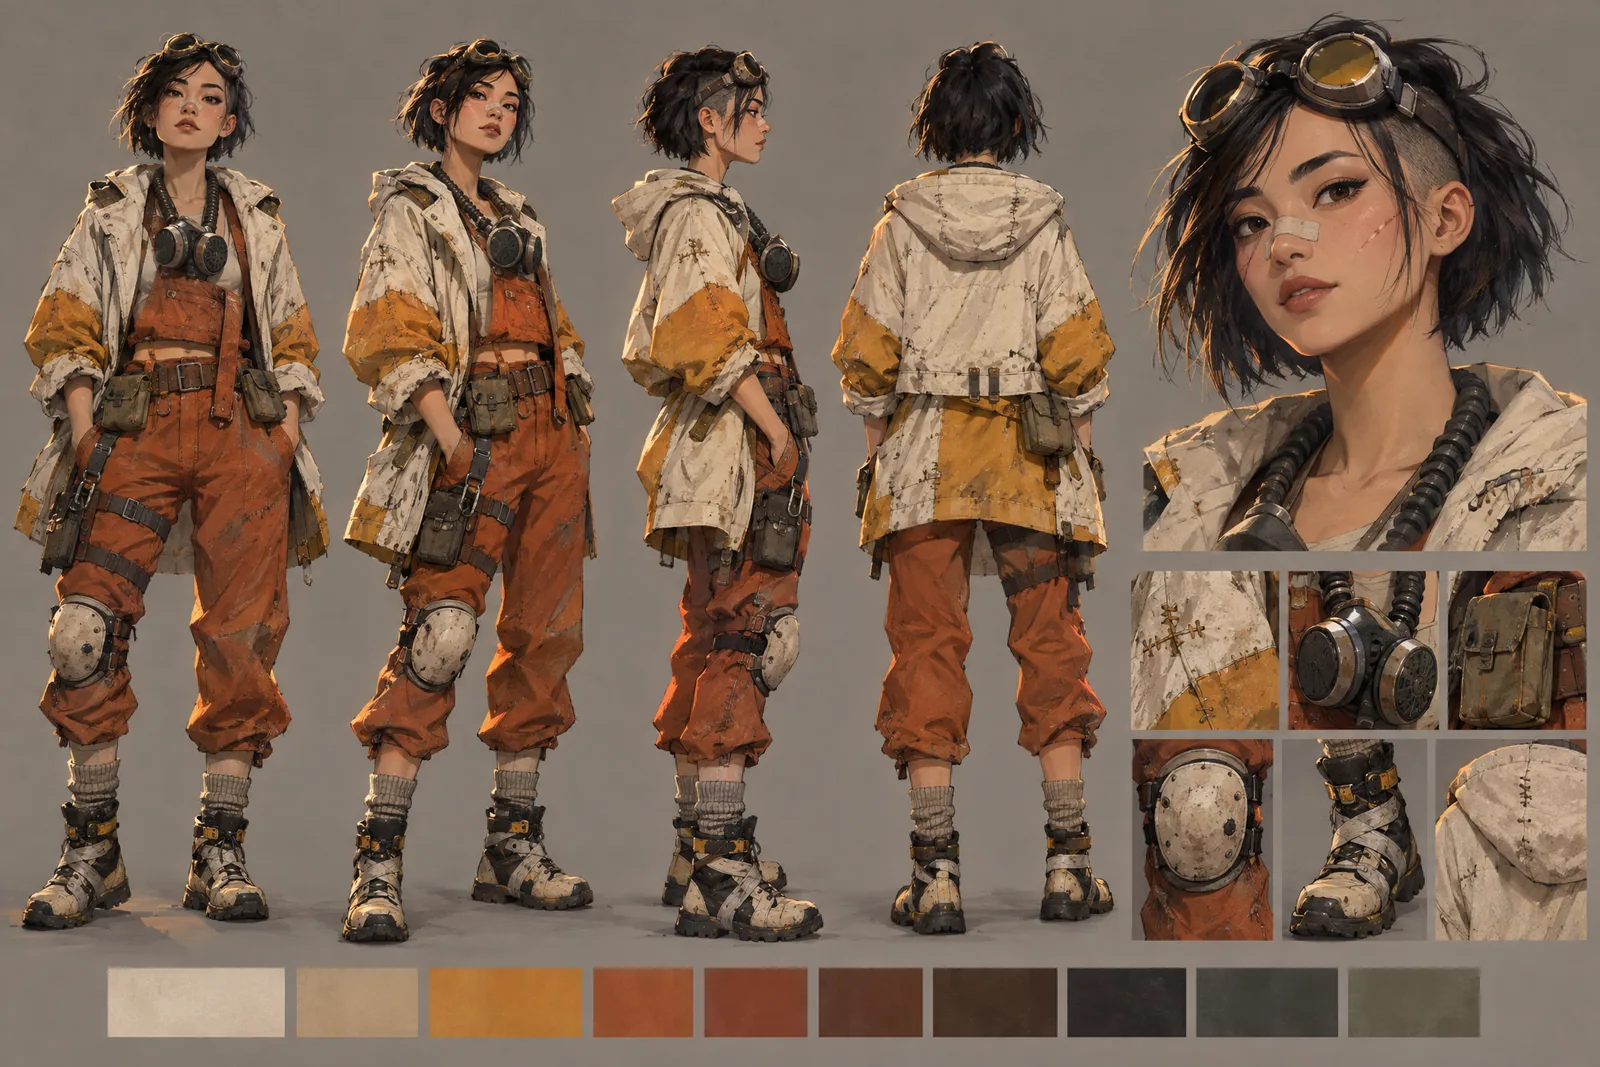
針對你已經搭建好的世界來設計他們。這個角色的裝扮就是為了在那種霓虹燈光下顯得協調。
鎖定角色
這是大多數人會跳過的一步,卻也是決定你的電影能否連貫統一的一步。從你的主角圖出發,生成多個角度的頭像和一個全身轉身鏡頭,然後將其保存為角色以便重複使用。
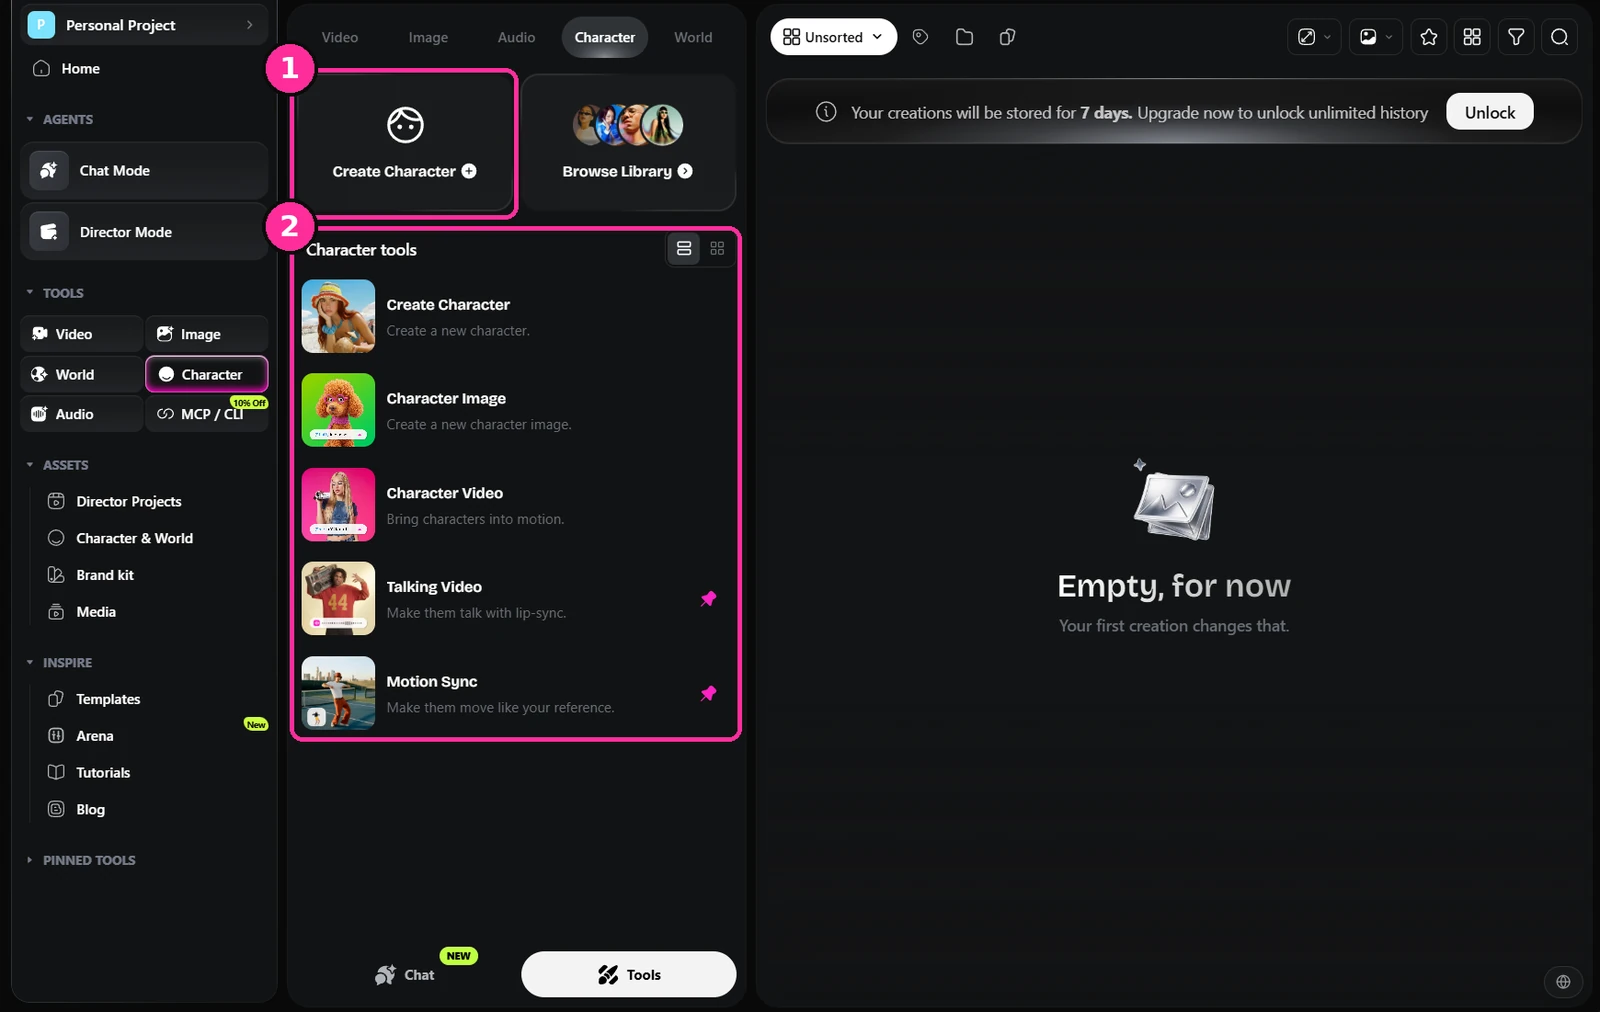
- Create Character。創建一個可重複使用的角色,而不是又一張一次性圖像。
- 角色工具。創建、圖像、影片、對話影片和動作同步都掛在同一個已保存角色之下。
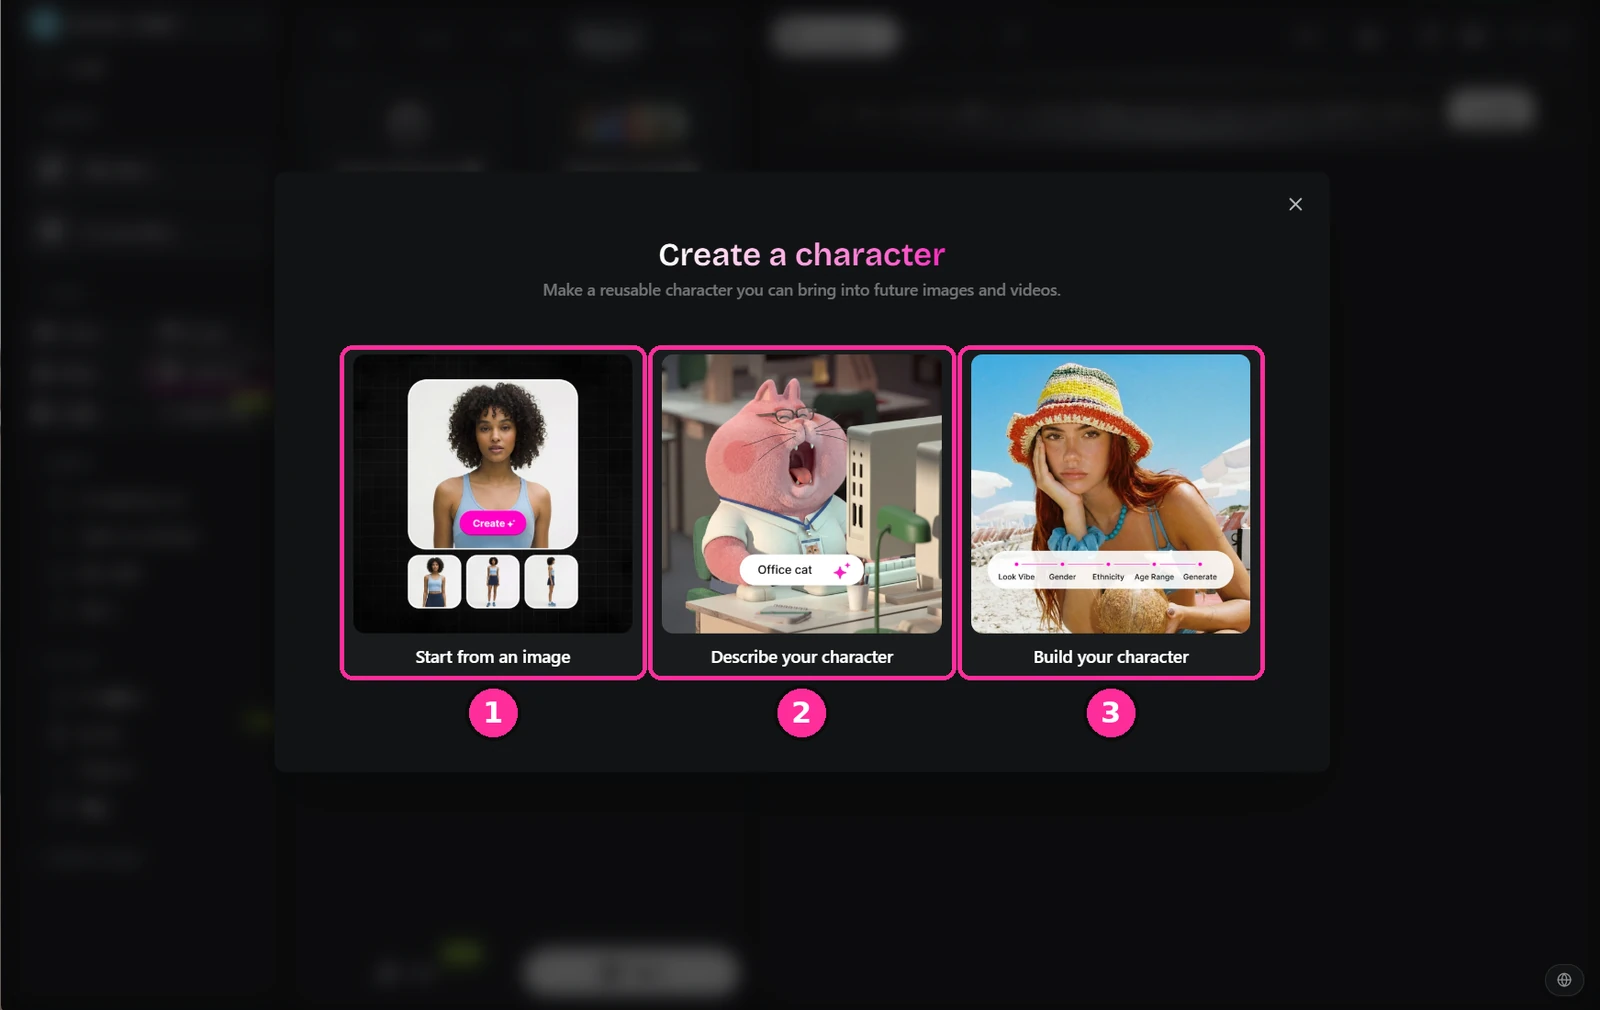
- 從圖像開始。我使用的方式——輸入你在第二步中批准的主角圖像。
- Describe your character。如果你是從零開始,僅用文字描述。
- Build your character。提供關於外觀、年齡等的引導式選項。
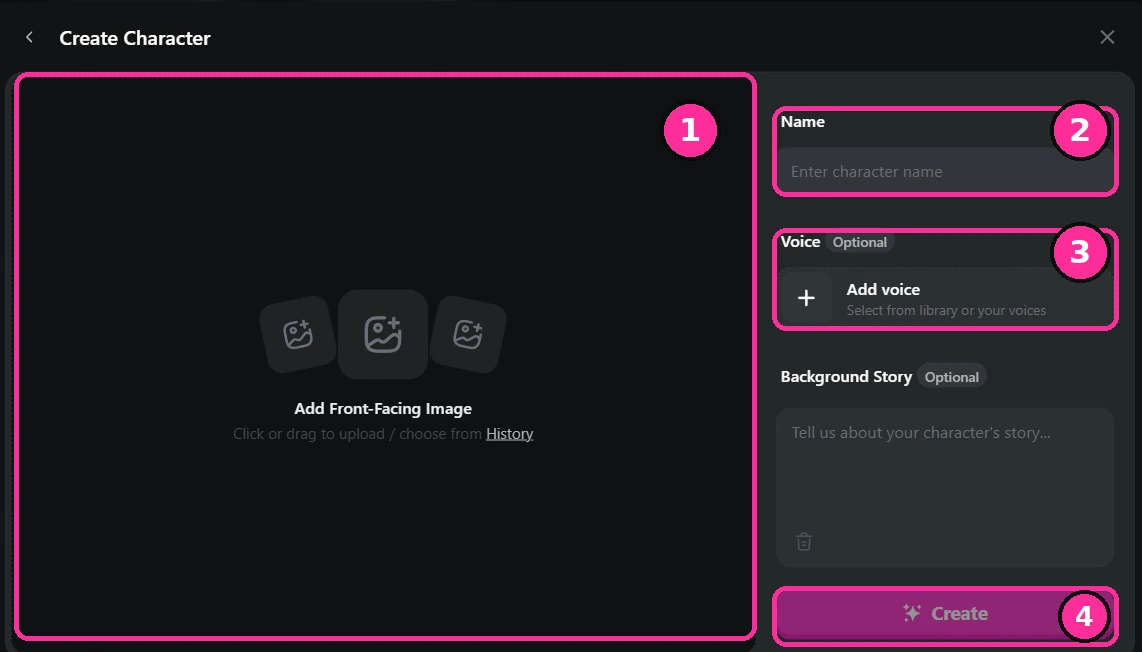
- 正面圖像。上傳已批准的主角靜態圖。正面、清晰、光線良好。
- 姓名。正式為他們命名。在後續的整個製作過程中,你都會從列表中選擇他們。
- 聲音。此處為可選項,但現在關聯好可以省去之後每個鏡頭都要單獨處理的麻煩。
- 創建。保存到你的素材庫中,可供每個工具使用。
角色設定表的提示詞寫法與場景相同,先說明版面配置,讓模型將各個畫格放在你想要的位置。
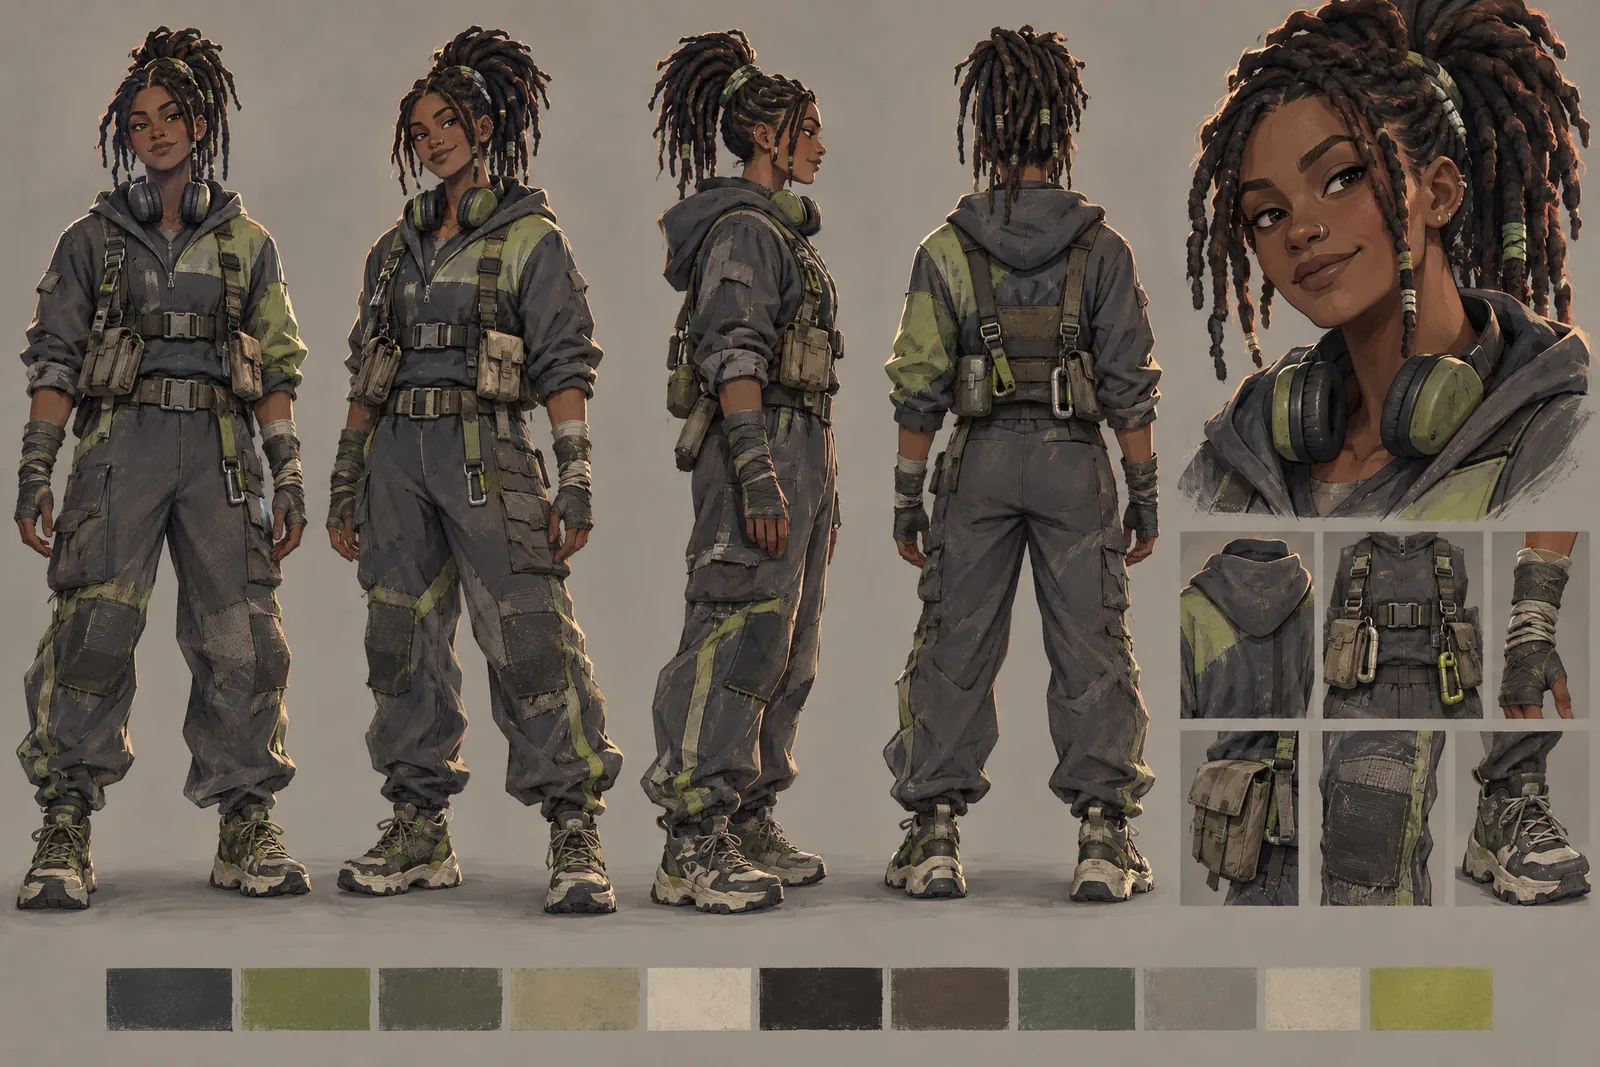
那一整套圖就是你的角色。在角色出現的每個鏡頭中,都把它作為參考圖重新提供,這樣角色在剪輯之間就不會再產生偏差。
撰寫場次,然後附加素材
現在寫下發生的事情。用平實的語言描述動作和表演——他們做了什麼、如何移動、感受如何——然後將你的場景和角色參考圖附加到提示詞中,讓模型基於你已經批准的內容進行構建,而不是憑空創造新的東西。
生成鏡頭
將已批准的畫面帶入影片製作。按鏡頭逐個進行,而不是按場次進行,並預期一個提示詞需要運行多次才能成功一次。可用率很低。這是正常的,而且仍然比雇用一個攝製組更快。
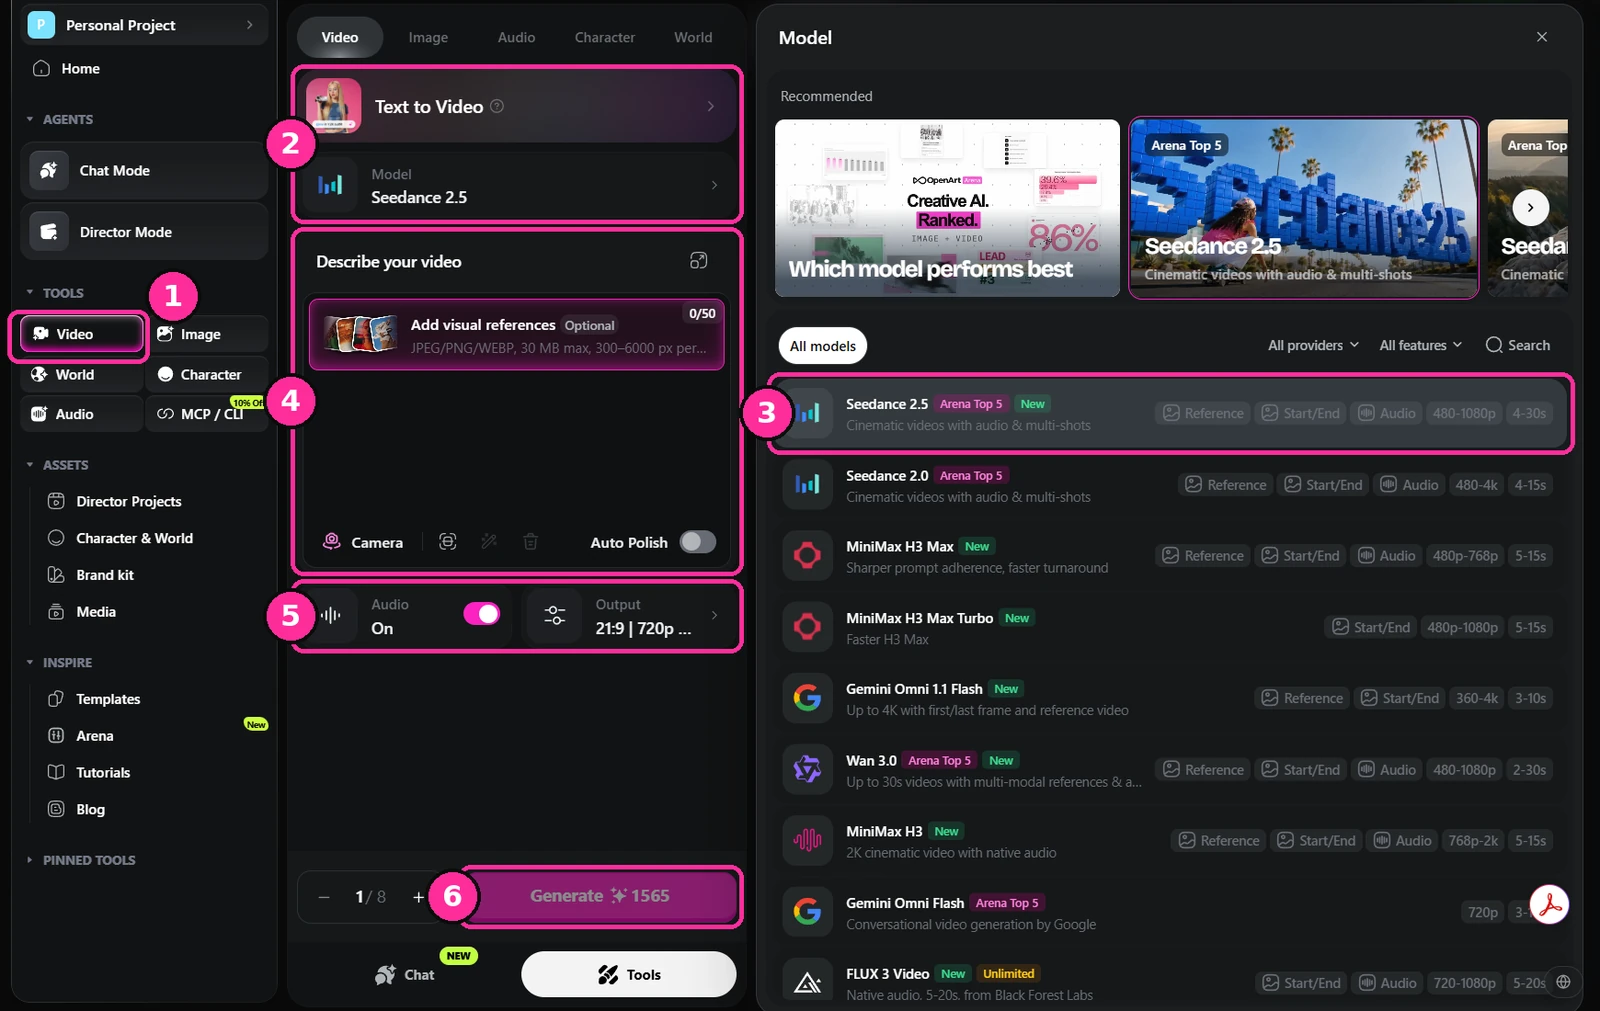
- 影片。切換到影片工具。
- 模式與模型。如果從零開始就用文字轉影片,如果是讓已批准的靜態圖動起來就用圖像轉影片——而現在你應該已經做到這一步了。
- 模型列表。每個模型都會顯示它支援的功能:參考圖像、起始與結束幀、原生音訊、解析度和片段時長。根據你真正需要的功能來選擇。
- 提示詞與參考圖像。你的場次描述,附帶角色和場景參考圖。
- 音訊與輸出。開啟或關閉原生音訊,以及寬高比和解析度設定。
- 生成。提交前請注意積分消耗。影片正是消耗積分最多的地方。
配音與音樂
兩者都位於音訊工具中,所以你永遠不必離開平台就能為場次配樂。配音使用 ElevenLabs——你可以從聲庫中選擇、根據描述設計一個新聲音,或克隆你自己的聲音。
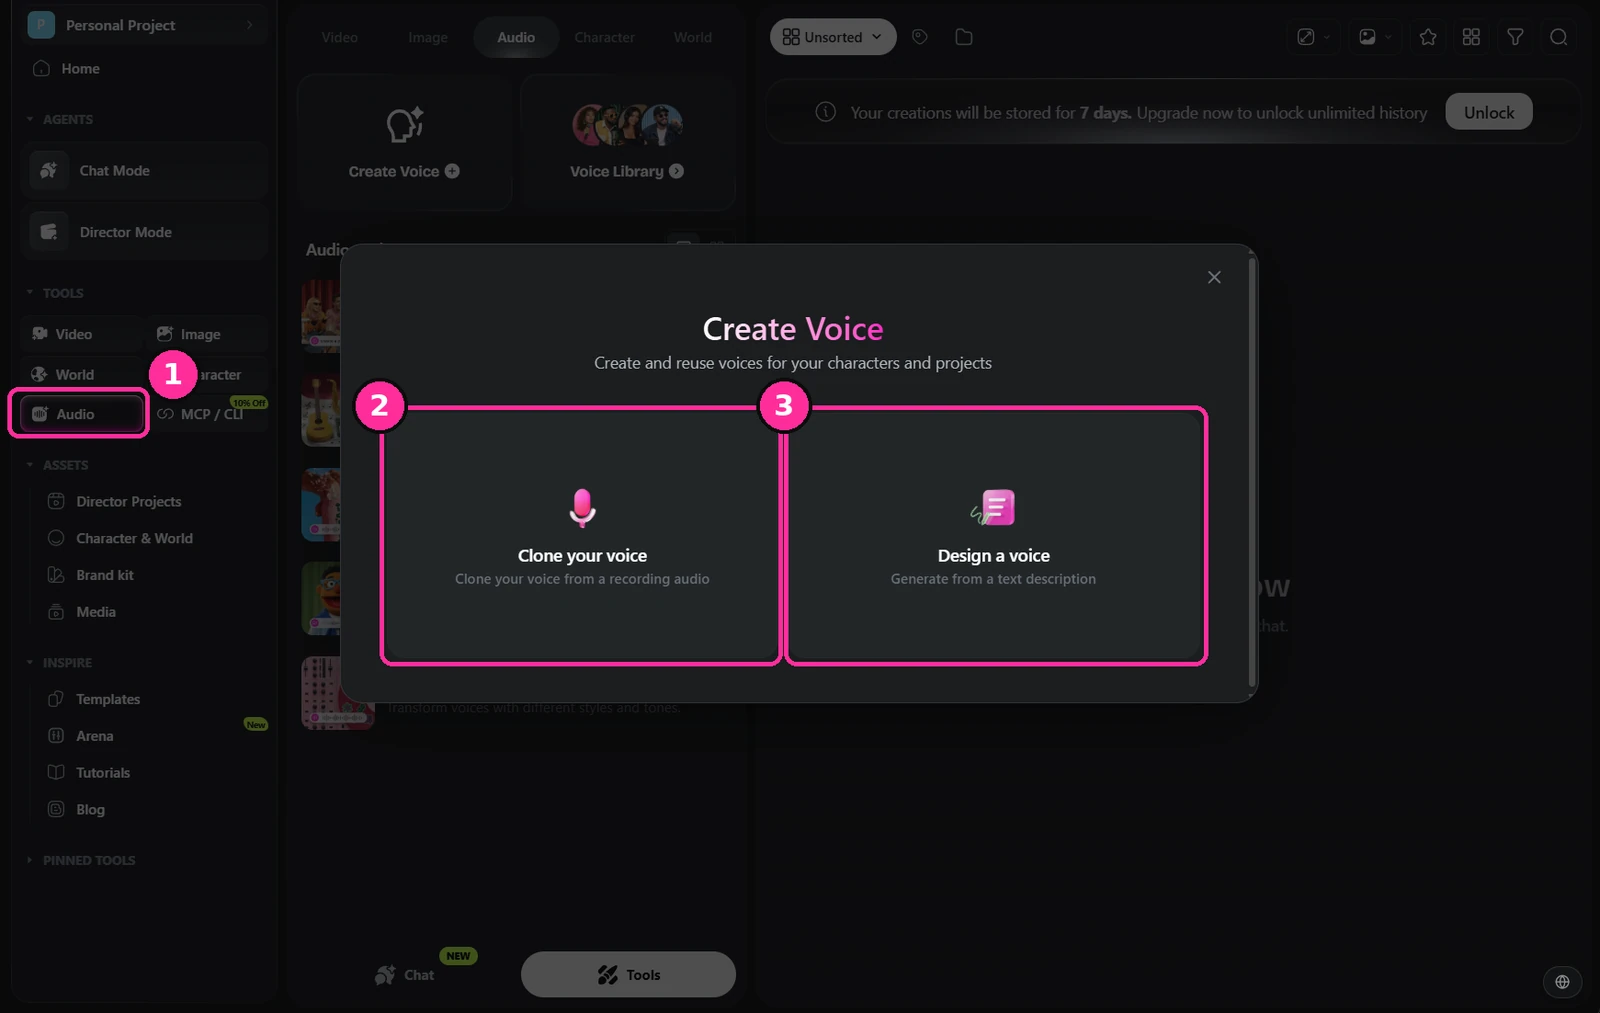
- 音訊。側邊欄中的音訊工具。
- Clone your voice。如果你要親自配音,可以基於一段錄音進行克隆。
- Design a voice。根據文字描述生成,適合為一組角色打造聲音。
音樂位於同一位置,在 Create Music 下。
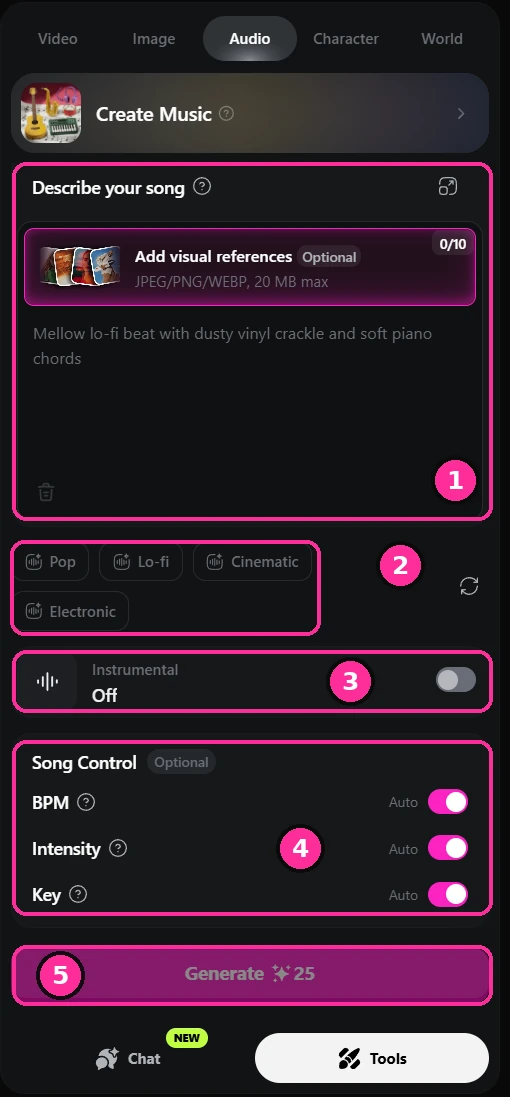
- Describe your song。像給作曲家寫簡報一樣撰寫:情緒、樂器、質感。你可以附加靜態圖,讓曲目根據畫面內容進行創作。
- 曲風。如果你不想從零開始撰寫,這裡提供快速起點。
- 純音樂。為配樂開啟此項。你幾乎從不希望在對白下方出現人聲。
- 歌曲控制。BPM、強度和調性,除非你需要命中特定要求,否則均設為自動。
- 生成。比影片便宜得多,所以可以多生成幾個再挑選。
剪輯、調色、交付
這部分工作在 OpenArt 之外完成。將你的片段、配音和音樂匯入合適的剪輯軟體,在那裡完成剪輯。如果想要快速簡單可以用 CapCut,如果想要更精細的控制可以用 Premiere Pro 或 DaVinci Resolve。CapCut 和 Resolve 都有免費版本,完全足夠完成一部電影。
電影是在剪輯中完成的,一直以來都是如此。節奏、聲音設計和配樂對一個場次的作用,遠超再來一輪生成。最後再進行調色,讓一切呈現在同一個世界裡。
排查你的生成結果
當影片沒有按你想像的樣子出來時,不要氣餒。一個鏡頭第一次就成功的次數,我用一隻手就能數得過來,而我做這行已經有一段時間了。
這項工作的關鍵不是不斷按下生成鍵並抱有期待。看看返回的結果,找出真正導致不想要的效果的原因,然後回到提示詞進行調整。可能是一個詞,也可能是整整一行,也可能是完全缺失了什麼,模型代替你自行補上了空白。
每次只改動一處,這樣你才知道是什麼造成了變化。提示詞中的一個詞就可能讓結果完全不同——這在兩個方向上都成立,而當你多次體會到這一點之後,你就會不再重寫整個提示詞,轉而做出一次有意為之的改動。
鏡頭完全不動。它停留在參考圖像原本所在的位置,導致兩個角色都顯得又小又遠,打鬥場面呈現為兩個你看不清的剪影。
力量特效畫面也失控——畫面被綠色淹沒,在十秒鐘的鏡頭中持續了三秒以上。色彩爆閃應該是一個標點符號,而不是整場戲。
相同的場次、相同的角色、相同的參考圖像。這一次鏡頭獨立於底板移動——繞到她的肩後,順著手臂而下,掠過子彈,轉向另一張臉。
綠色特效只持續四分之一秒,拳頭也只命中一次。讓第一次嘗試看不清的一切,都是提示詞的問題,而不是模型的問題。
這還不是一個完成的鏡頭,以目前的狀態我也不會把它剪進場次裡。但它已經足夠成熟,可以繼續打磨——而這正是在這個階段對一次嘗試的全部要求。
下一輪修改會把它拆開來處理。目前拳頭是在一個連續動作中完成的。我會剪成她直衝鏡頭出拳,這比從側面觀看更有衝擊力,然後再剪到命中的瞬間以及她後退的動作。空間感是另一個要點——你應該清楚地知道兩人在鏡頭的每一刻相對彼此的位置,而在動作進行到中段時,這種空間感被丟失了。
這兩次嘗試都來自同一次會話,相隔僅幾分鐘,使用相同的設定。
常見問題
你用哪些工具製作 AI 電影?
圖像方面我使用 GPT Image 2 和 GPT Image 2.5、Seedream 5.0 Pro 以及 Nano Banana Pro。具體選用哪個取決於鏡頭需求。
影片方面我只使用 Seedance 2.5,沒有其他。
以上是模型。我運行它們的平台是 OpenArt,它將圖像模型和影片模型集中在一處,並共用相同的參考圖像,這樣我就不需要在四個不同的網站之間搬運檔案來完成一個鏡頭。
你如何防止 AI 角色在鏡頭之間發生變化?
在拍攝任何內容之前,你要先鎖定角色。生成一張你滿意的主角圖像,然後用它構建一套參考素材:多個角度的頭像和一個純色背景下的全身轉身鏡頭。
角色出現的每一個鏡頭都會附加這套素材。如果沒有它,模型每次生成都會重新構想這張臉,結果沒有任何一個鏡頭能剪在一起。
製作 AI 電影需要高效能電腦嗎?
不需要。模型運行在平台的伺服器上,而不是你的裝置上,所以你只需要一個網頁瀏覽器和一個良好的網路連線。不需要安裝任何東西,也沒有任何本地渲染。
唯一會用到你自己硬體的部分是最後的剪輯,而 CapCut 或 DaVinci Resolve 在普通筆記型電腦上就能運行。
製作一部 AI 電影要花多少錢?
沒有一個誠實的確切數字,任何給你一個具體數字的人都只是在猜測。它會因你選擇的模型、解析度、片段長度而變化——更重要的是,取決於一個鏡頭需要嘗試多少次才能成功。
它按每次生成的積分計價,不論結果是否可用都要收費。請為一個鏡頭準備多次嘗試的預算,而不是只做一次。
唯一能可靠壓低費用的辦法是:先在低解析度下測試提示詞,只有在確定要保留的那次嘗試上才升級到完整解析度。
一段 AI 影片片段能有多長?
我用的 Seedance 2.5 一次可以生成 4 到 30 秒。大多數其他模型更短,所以在確定鏡頭長度之前先確認一下上限。
這個數字指的是你在一次生成中能獲得的連續鏡頭長度,而不是你的電影總時長。成片仍然需要在剪輯軟體中逐個鏡頭進行組裝,與其他電影別無二致。
鏡頭生成完成後,電影就算完成了嗎?
還沒有。模型輸出的是原始素材——單獨的鏡頭,沒有順序,沒有節奏,也沒有聲音設計。這更接近拍攝日結束時你手上會有的東西,而不是一部電影。
電影是在之後於剪輯軟體中製作完成的:挑選要使用的鏡次、將它們剪接在一起、把控節拍時機、加入音樂和聲音,並對一切進行調色,使其呈現在同一個世界裡。
這一部分完全沒有改變,也正是它決定了成品是感覺像一部電影,還是像一段作品集展示。CapCut 和 DaVinci Resolve 都有免費版本,能完成其中的每一個環節。
可以把 AI 電影發布到 YouTube 上嗎?
可以,AI 電影是被允許的。YouTube 的要求是,當內容逼真到觀眾可能誤以為真實時,你需要進行揭露。這是上傳流程中的一個開關,位於已變更或合成內容選項下。
讓頻道陷入麻煩的,是大規模生產、重複性的上傳內容,而其中沒有任何原創性——問題不在於 AI 本身。
這些規則會不斷變化,所以請查閱 YouTube 官方頁面,而不是把我說的話當作最新依據:揭露已變更或合成內容的使用情況。
為什麼模型會忽略我提示詞的一部分?
因為模型會選擇最短、最簡單的路徑來生成符合你要求的內容。如果你把某部分留得模糊不清,模型就會替你做決定,而它做出的決定永遠是最容易生成的那個。鏡頭保持不動。角色留在原地。困難的事情會悄無聲息地不發生。
所以你必須強迫它走更難的那條路。對你真正在意的事情要明確表述,不要給它留下用更簡單方式替代的空間。
當某些內容被忽略時,每次只改動一處並重新生成,這樣你才能知道是哪個詞造成的。重寫整個提示詞並不會告訴你任何有用資訊。
這就是目前大部分的技藝所在。我預計這會變得更容易,但眼下你確實需要真正推動它去完成較難的那個版本。
目前哪些 AI 模型實際上是最好的?
這取決於誰在評判,以及評判的用途。我關注的是 OpenArt Arena,因為它由業界導演和藝術家進行盲評,而不是公開投票,而且是按工作類型分類的——影視、廣告、動畫、動效設計、口型同步、電商、平面設計。在廣告類別獲勝的模型未必就是你想要的電影模型。
影視類排行榜才是這裡最重要的。本頁頂部的這一欄,就是從他們的排行榜中提取的當前影視影片和影視圖像前三名的即時快照,因此展示的是今天為真的情況,而非我寫這篇文章時為真的情況。
有一點提醒比排名本身更重要:排行榜的榜首並不等同於適合你鏡頭的模型。我在所有影片工作中都使用 Seedance 2.5,是因為它處理參考圖像的方式以及單個片段能持續的時長,而不是因為它在某個排行榜上的位置。
J2 industries 與 OpenArt 存在商業合作關係,本頁面的連結可能帶來佣金收入。上述工作流程正是我們自己製作過程中所使用的方式。